Java RAG 十篇写完:80% 的项目卡在这五步
十篇 Java RAG 合集到这就全更完了。回头看后台数据和读者留言,我发现一个规律:卡住大多数项目的,不是模型不够强,不是代码写不出来,是五个非常具体的地方。这篇作为系列收官的复盘,把十篇浓缩成一张地图加一份避坑清单——正在做 RAG 的,对着看一眼自己卡在第几步。
读完你应该能: - 拿到全系列的完整地图,知道每篇解决什么问题 - 对号入座:你的项目卡在五步中的哪一步 - 知道如果时间只够读三篇,该读哪三篇
一、先上全系列地图
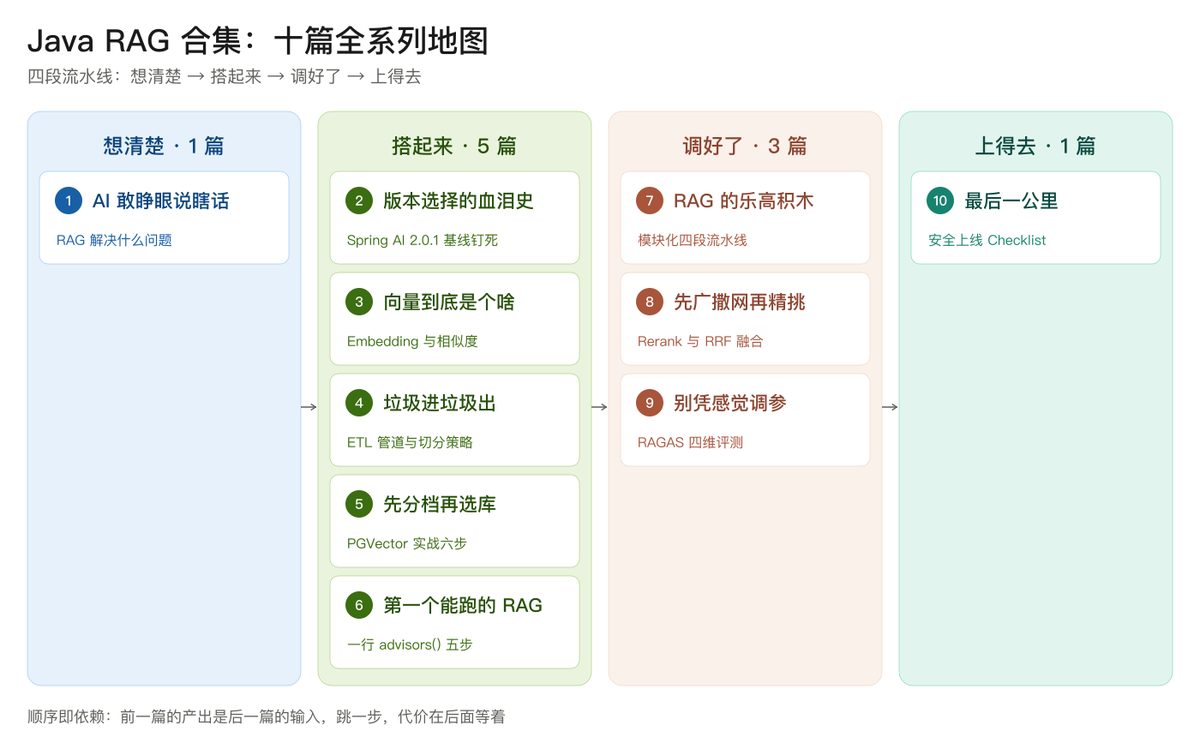
十篇是一条完整的流水线,硬要归类的话是四段:
- 想清楚(①):RAG 到底解决什么问题
- 搭起来(②③④⑤⑥):版本基线、向量、文档切分、向量库、第一个能跑的 RAG
- 调好了(⑦⑧⑨):模块化流水线、两阶段检索、评测指标
- 上得去(⑩):安全、性能、成本、可观测
顺序不是随便排的。前一篇的产出是后一篇的输入,跳步的代价后面每一步都会还。
二、五步避坑清单:对号入座
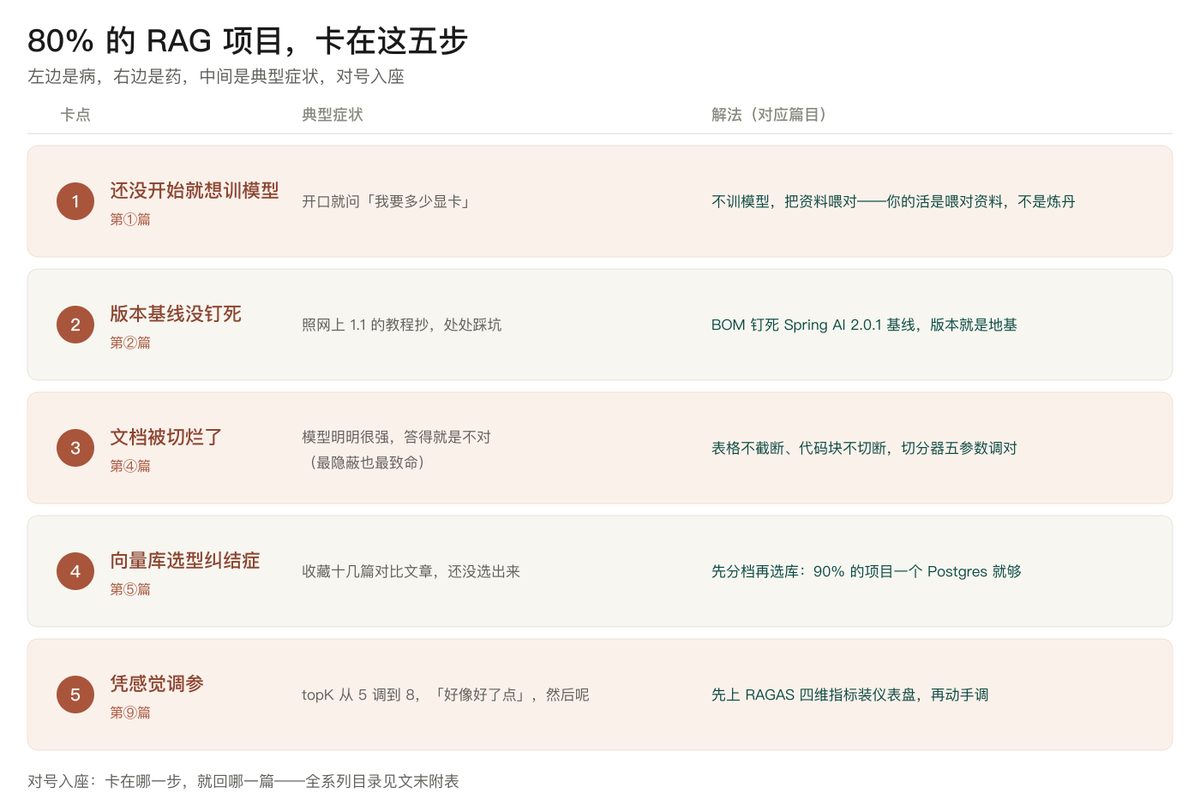
坎 1:还没开始就想训模型。典型症状是开口就问「我要多少显卡」。RAG 的核心是不重新训练模型,让 AI 带着你的资料回答问题(第①篇)。训练是模型厂的事,你的活是把资料喂对。这一步想歪了,后面全是弯路。
坎 2:版本基线没钉死。Spring AI 2.0.1 已经 GA 三个月,网上教程还在教 1.1,照着抄必踩坑(第②篇)。BOM 钉版本、配置扁平化、国内模型接入,这些坑一次讲透过——版本就是地基,地基歪了楼上全歪。
坎 3:文档被切烂了。这是我认为最隐蔽也最致命的一步:RAG 效果差,八成不是模型的锅,是文档被切烂了(第④篇)。表格被截断、代码块被切断、切分器参数瞎填——垃圾进垃圾出,后面检索再准也救不回来。症状是「模型明明很强,答得就是不对」,先查这里。
坎 4:向量库选型纠结症。收藏了十几篇对比文章还没选出来。第⑤篇的结论很简单:先分档再选库,数据量定档位,运维能力定上限——90% 的项目一个 Postgres 就够。别用 Netflix 的架构标准给自己公司三个集合的检索做选型。
坎 5:凭感觉调参。topK 从 5 调到 8,感觉「好像好了点」,然后呢?「感觉不错」不是工程答案(第⑨篇)。RAGAS 四维指标给 RAG 装仪表盘:建评测集、LLM-as-Judge 评判、按指标定位短板。没有指标的调参就是抛硬币。
三、如果只读三篇:⑨④⑩
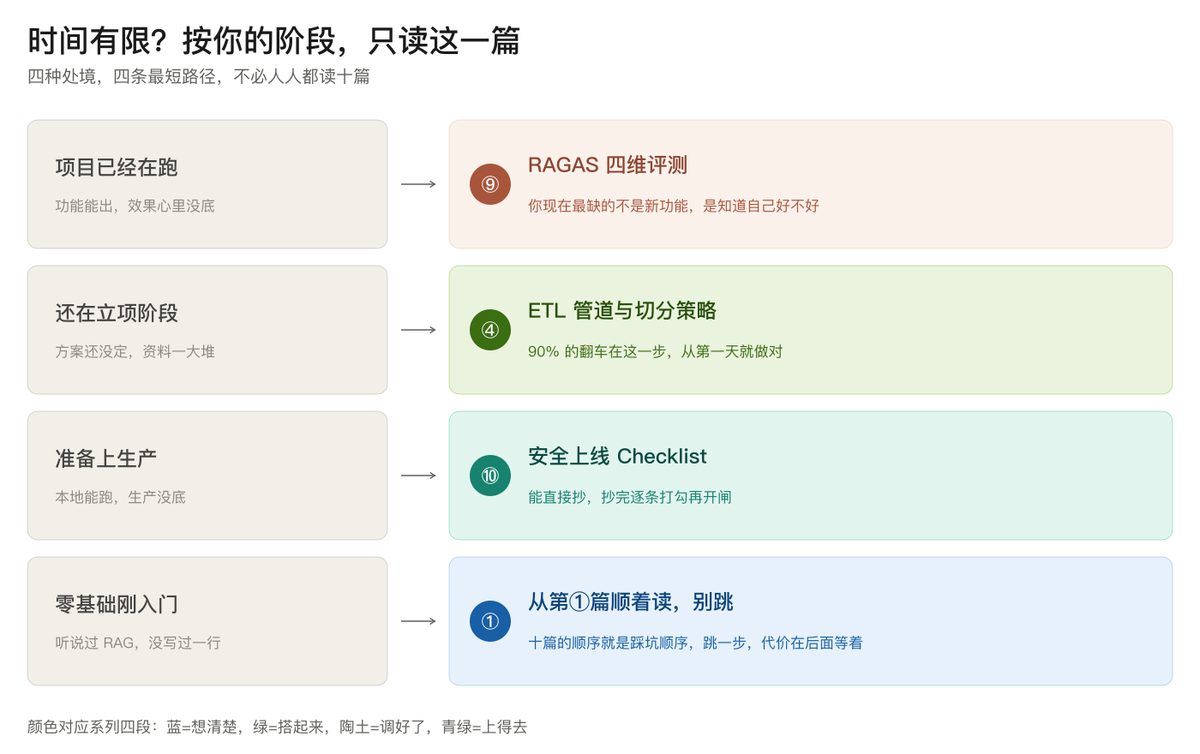
已经有项目在跑的,优先读第⑨篇(评测)——你现在最缺的不是新功能,是知道自己好不好。
还在立项阶段的,优先读第④篇(ETL 切分)——90% 的翻车在这,从第一天就把文档处理做对。
准备上生产的,直接翻第⑩篇末尾的上线 Checklist——能直接抄,抄完逐条打勾。
零基础从零开始的,老实从①顺着读,别跳。十篇的顺序就是踩坑顺序,跳一步,代价在后面等着。
四、写完十篇,说点真心话
这个系列写了半个多月,最深的感触是:RAG 这个领域,信息过载但工程常识稀缺。网上不缺高大上的架构图,缺的是「表格别切烂」「版本要钉死」「先有评测再调参」这种大白话。
AI 编程工具再强,最后拼的还是这些基本功。工具能把代码写出来,但「这个项目该不该做、卡在哪、怎么验证」——判断还是你的。
系列完结,但选题库已经排好下一批:Cursor vs Claude Code 实测、RAG 框架选型对比、1000 个 PR 看 AI 到底写了多少代码。想追更的,公众号右上角设个星标。
附:全系列目录
- ① AI 为什么敢睁眼说瞎话 — RAG 解决什么问题:不训模型,带资料回答
- ② 版本选择的血泪史 — Spring AI 2.0.1 基线,BOM 钉版本
- ③ 向量到底是个啥 — Embedding 与余弦相似度的人话版
- ④ 垃圾进垃圾出 — ETL 管道与切分策略,效果差的头号元凶
- ⑤ 先分档再选库 — 90% 项目一个 Postgres 够,HNSW 三参数
- ⑥ 第一个能跑的 RAG — 一行 advisors() 背后的五步
- ⑦ RAG 的乐高积木 — 模块化四段流水线,查询改写与兜底
- ⑧ 先广撒网再精挑 — 两阶段检索:粗召回 + Rerank + RRF 融合
- ⑨ 别凭感觉调参 — RAGAS 四维指标,评测挂进回归测试
- ⑩ 最后一公里 — 安全/性能/成本/可观测,上线 Checklist