Java RAG 合集①:AI 为什么敢睁眼说瞎话
问你公司里那个"大模型问答助手"一个问题试试:
"我们公司去年的报销流程是什么?"
它大概率会给你一段听起来特别专业、特别合理、特别像那么回事的回答。三级审批、5000 块以下、每月 10 日前提交……
然后你去问财务,财务说:"我们根本没这制度。"
恭喜你,你的 AI 正在一本正经地胡说八道。
这篇不写一行代码,先把"为什么"讲透。
一、大模型的三个先天缺陷
不是说现在的 LLM 不行,它很强——能写诗、能解方程、能写代码。但它从娘胎里出来那天就带着三个解决不了的硬伤。
| 缺陷 | 怎么来的 | 后果 |
|---|---|---|
| 知识静态 | 训练数据有截止日期 | 你问"上个月公司上了什么新品",它答不上来 |
| 无私有数据 | 训练时根本没见过你的内部资料 | 问公司制度、产品文档、合同条款,全瞎蒙 |
| 幻觉 | 模型天生擅长"组织语言",不擅长"分得清真假" | 没有的资料它会编一套,听起来还特别合理 |
这三个缺陷里,幻觉最致命。
因为模型"看起来永远自信"。它编一个东西,措辞流畅、逻辑通顺、语调专业。你作为用户,根本分不清它哪句话是在背答案、哪句话是在现场编。这是企业场景里最危险的——比答不出来更危险,因为它会误导决策。
二、RAG = 检索 + 增强 + 生成
想把这三个缺陷都治了,思路有两条:
- 重新训练 / 微调模型——把新知识灌进参数里
- 不训练模型,给它资料让它查——开卷考试
第一条路:成本是几百万到几亿美元、周期是几周到几个月、副作用是会"灾难性遗忘"(学了新的忘了旧的)。99% 的企业负担不起。
第二条路:成本是 RAG 系统的搭建和运维,是微调成本的 1/10 到 1/100。这就是 RAG。
RAG = Retrieval-Augmented Generation,检索增强生成。
把它掰开:
- Retrieval(检索):用户提问时,先去你的私有资料库里找相关的内容
- Augmented(增强):把找到的内容和原始问题拼成一段更长的"开卷考题"
- Generation(生成):把这段拼好的题交给 LLM,让它基于"资料"而不是"记忆"回答
本质上,RAG 把 LLM 从"闭卷考生"变成了"开卷考生"。它不改变模型本身,只是给它发了一本参考书。
三、RAG 全景:一条离线,一条在线
RAG 系统跑起来其实就两段路,看懂这张图你就有 80% 的认知了:
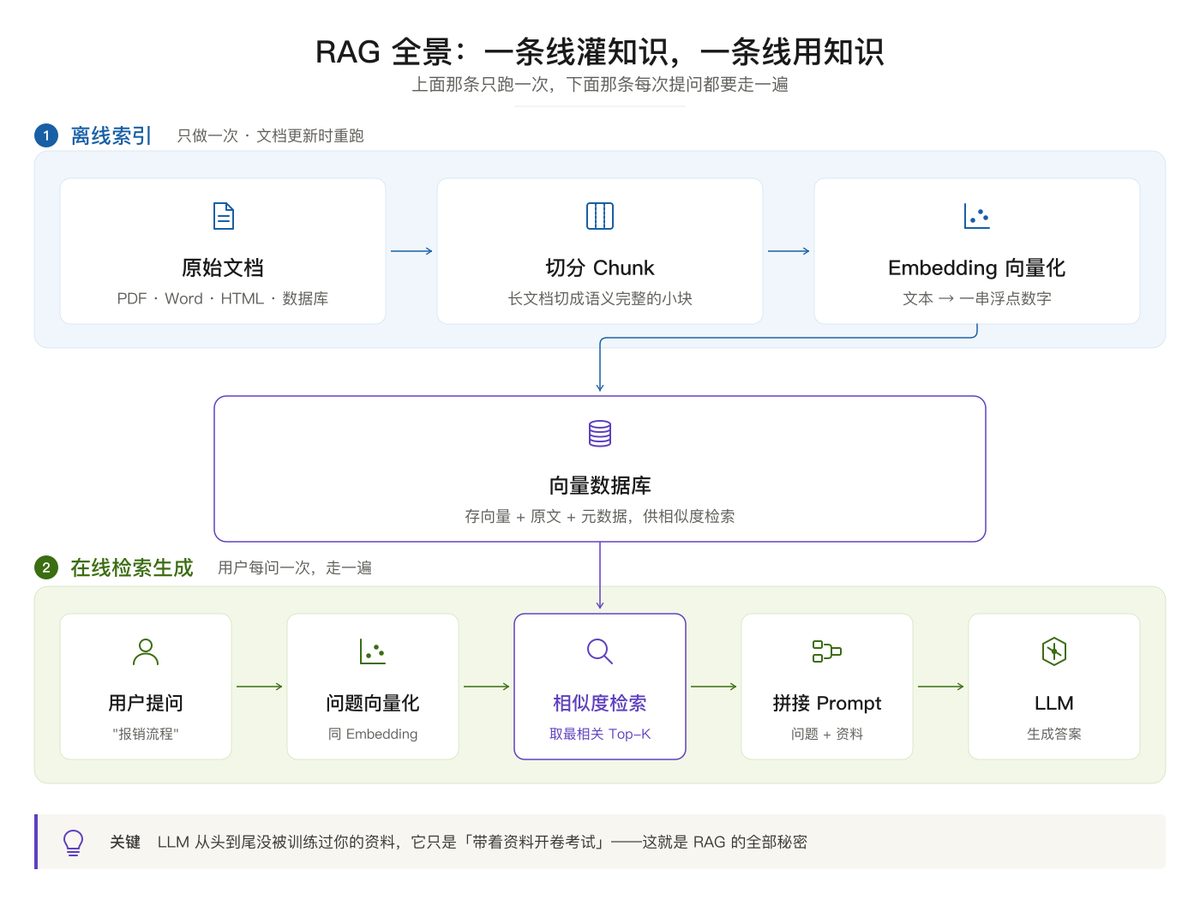
上半段:离线索引——只做一次,文档更新时重跑。
你的 PDF、Word、HTML 文档先要被「切分」成语义完整的小块(Chunk),然后每块被一个 Embedding 模型变成一串数字(向量),最后向量+原文+元数据一起塞进向量数据库。
下半段:在线检索生成——用户每问一次,走一遍。
用户的问题先被同一个 Embedding 模型变成向量(必须用同一个模型,否则坐标系对不上),然后去向量数据库里找最相似的 Top-K 块,找到了拼进 Prompt,最后交给 LLM 生成答案。
就这么简单。整个 RAG 系统的核心是一个向量数据库,外加一个聪明的 Embedding 模型。 其他的 ChatClient、Advisor、TokenTextSplitter 都是 Spring AI 帮你封装好的"工具人"。
四、同一问题,两种命运
光说原理太抽象,我拿开头的"报销流程"再画一张对比,你直观感受一下:
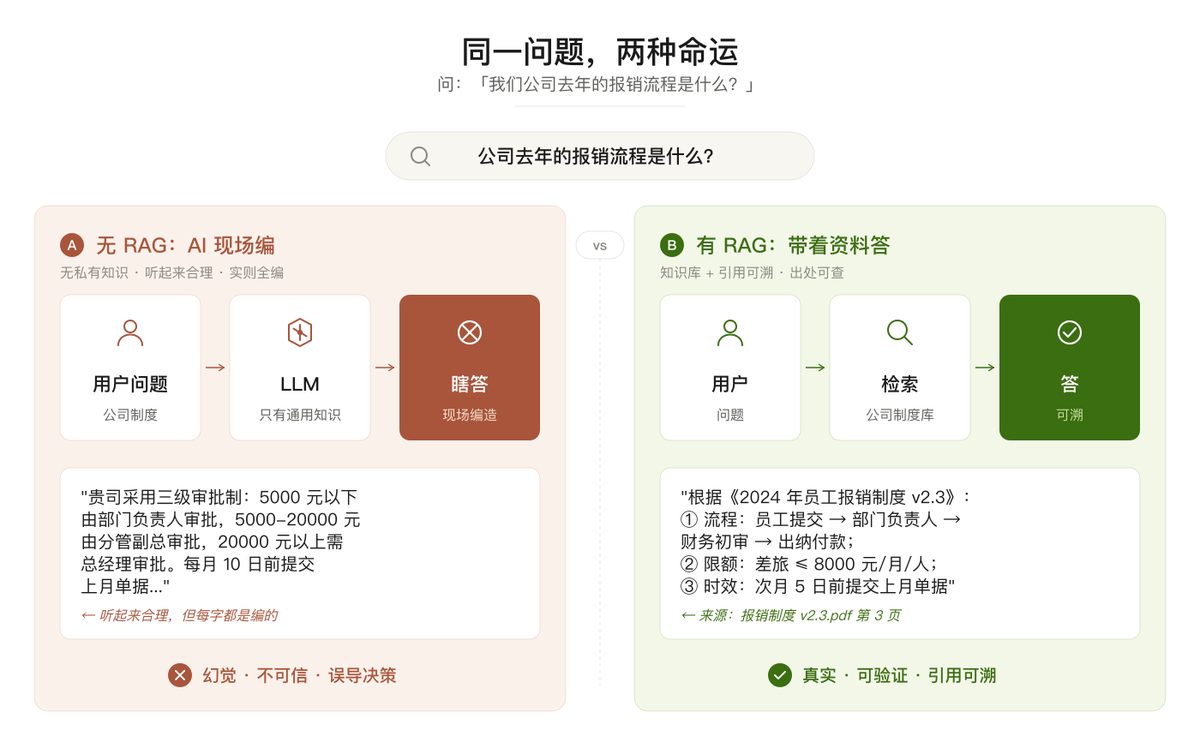
左半边没接 RAG,模型"现场编",编出来的制度听起来很合理,但每个字都是幻觉。员工照着它去报销,不是被财务退回就是要重填单据。
右半边接了 RAG,模型"带着资料答",答案里有具体制度名(v2.3)、有具体数字(差旅 8000/月/人)、还有引用源(PDF 第 3 页)——每一句都能溯源,每一句都能验证。
这就是 RAG 的核心价值:把 AI 从"看似可靠的幻觉机"变成"可审计的企业知识助手"。
对于金融、医疗、法律、企业内部知识库这类场景,可溯源 ≠ 可选项,是必选项。
五、为什么 Java 选 Spring AI,不转 Python
我知道你想说:"RAG 不是 Python 的强项吗?LangChain / LlamaIndex 不是更成熟?"
对,它们更早、更灵活。但你不是 Python 团队,你是 Java 团队。
- 你们公司已经有一套运行在 JVM 上的生产系统
- 你们是 Spring Boot 写的业务、Spring Cloud 写的微服务
- 引入 AI 能力如果需要维护一套 Python 边车服务,多一套部署、多一套监控、多一套权限合规
Spring AI 的定位就是:让 Java 团队用写 Spring Boot 业务代码的姿势去调 AI。 模型切换像切换数据源一样简单,依赖注入、AOP、配置中心、链路追踪全都能复用。
到 2026 年 9 月,Spring AI 2.0.1 是当前稳定版(2.0.0 GA 刚在 6 月 12 日发),基于 Spring Boot 4.x + Java 17/21,官方主推。这套生态已经足够撑起一个生产级 RAG 系统。
本合集全程用 Spring AI 2.0.1 + Java 21 + Spring Boot 4.x。
六、合集路线图
第 1 篇讲完"为什么",后面 9 篇全是"怎么做":
| # | 主题 | 核心干货 |
|---|---|---|
| ② | 版本选择的血泪史 | 2.0 vs 1.1 vs LangChain4j + Hello World |
| ③ | 向量到底是个啥 | Embedding 与相似度的人话版 |
| ④ | 垃圾进,垃圾出 | ETL 管道与切分策略 |
| ⑤ | 向量库选型 + PGVector 实战 | 包含 initialize-schema 的坑 |
| ⑥ | 第一个能跑的 RAG | QuestionAnswerAdvisor |
| ⑦ | 模块化 RAG | RetrievalAugmentationAdvisor 进阶 |
| ⑧ | Rerank 与混合检索 | 召回质量的第二次跃迁 |
| ⑨ | RAGAS 四维评估 | 别再凭感觉调参 |
| ⑩ | 上线 | 安全、性能、成本与可观测 |
每一篇都会带完整可运行的代码、代码渲染的架构图(这次是 SVG,文字 100% 准确,AI 生图做不到),以及生产环境踩过的坑。
写在最后
合集 10 篇,会涉及到 Spring AI 的所有核心模块、向量库的选型对比、ETL 全流程、检索优化、评估体系、上线清单。
老规矩:先点赞、点"在看"——这套东西写完要两个月,中间不靠"在看"撑着,我怕我会偷懒。
下一篇《版本选择的血泪史》,我们从 Spring AI 2.0 的环境搭建开始。下次见。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线(Spring AI 2.0.1) 下期:版本选择的血泪史:Spring AI 2.0 环境搭建 + Hello World