Java RAG 合集④:垃圾进,垃圾出——ETL 管道与切分策略
上篇我们把"一句话怎么变成一串数字"讲透了。但有个事我一直憋着没说:
Embedding 之前,文档得先切好块。切错了一切白搭。
你满怀期待地把公司手册扔进系统,问了句"年假怎么折算",AI 一本正经地胡说八道。你的第一反应是"这模型不行",换 GPT-5、换 Claude,还是胡说。
八成不是模型的问题,是你的文档被切烂了。 计算机圈有条老话:Garbage In, Garbage Out——垃圾进,垃圾出。这一篇就讲怎么不往系统里灌垃圾。
读完你应该能:
- 搞懂 Spring AI 的 ETL 管道三段式:读 → 切 → 写
- 知道 TokenTextSplitter 五个参数各管什么(2.0 构造函数已废弃,网上教程还在教老写法)
- 会选切分策略:固定 / 按标题 / 语义
- 避开两个致命坑:表格被拦腰截断、代码块被切断
一、ETL 管道:读 → 切 → 写
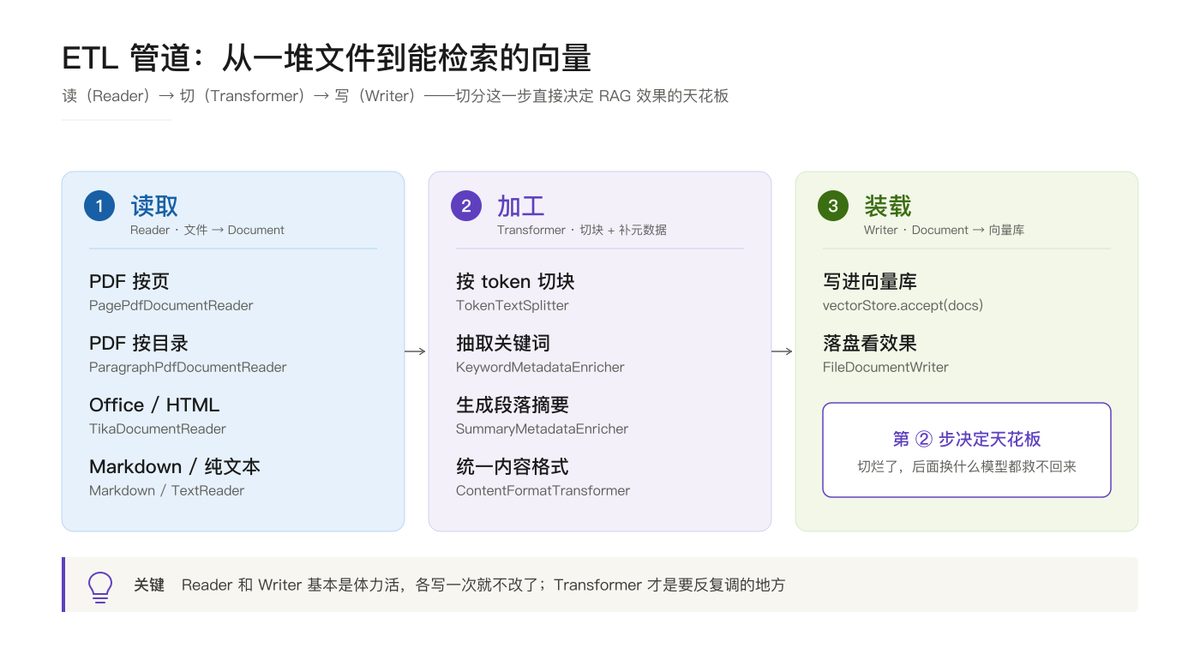
Spring AI 把"把文档变成向量库里的数据"这件事抽象成了三段:
- 读取
DocumentReader:文件 →Document对象,选对实现类就行 - 加工
DocumentTransformer:切块 + 补元数据——核心!反复调的地方 - 装载
DocumentWriter:Document→ 向量库,一次写好基本不动
Reader 和 Writer 是体力活,Transformer 才是技术活。 块切得好不好,直接决定后面检索的天花板——切烂了,你换什么模型都救不回来。
Reader 怎么选
Spring AI 内置了一堆 Reader,按文件类型对号入座:
| 你的文件 | 用哪个 Reader |
|---|---|
| PDF 按页(最常用) | PagePdfDocumentReader |
| PDF 按段落(排版规整) | ParagraphPdfDocumentReader |
| Word / PPT / HTML(万金油) | TikaDocumentReader |
| Markdown / 纯文本 | TextReader / MarkdownDocumentReader |
| JSON(结构化数据) | JsonReader |
PDF 加依赖(以 PGVector 篇为例,其他向量库同理换 artifact):
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>
读一下:
PagePdfDocumentReader reader = new PagePdfDocumentReader(
        "classpath:/company-handbook.pdf",
        PdfDocumentReaderConfig.builder()
                .withNumberOfTopPagesToSkipBeforeRead(2)  // 跳过封面、目录页
                .build());
List<Document> docs = reader.get();
坑 3:网上有教程说能配"只读第 3-5 页"——没有这个 API。2.0 只有
withNumberOfTopPagesToSkipBeforeRead(n)跳过前 N 页,不能指定页区间。想要某几页?自己subList()去。坑 4:
spring-ai-pdf-document-reader修过递归漏洞(CVE-2026-47851)。务必用 2.0.1 及以上,老版本读恶意构造的 PDF 可能栈溢出。
二、TokenTextSplitter:五个参数,一个都不能瞎设
切分的主力选手是 TokenTextSplitter。先把 2.0 的正确写法亮出来:
TokenTextSplitter splitter = TokenTextSplitter.builder()
        .withChunkSize(800)          // 每块目标 token 数(默认 800)
        .withMinChunkSizeChars(350)  // 每块最少字符数(默认 350)
        .withMinChunkLengthToEmbed(5)// 短于这个数的块直接丢弃(默认 5)
        .withMaxNumChunks(10000)     // 单文档最多切多少块,防失控(默认 10000)
        .withKeepSeparator(true)     // 保留分隔符,如 markdown 的 ##(默认 true)
        .build();

List<Document> chunks = splitter.apply(docs);
坑 5(本篇最大坑):
TokenTextSplitter的构造函数在 2.0 已标记废弃。网上 90% 的教程还在教new TokenTextSplitter(800, 350, 5, 10000, true)——五个裸参数,IDE 直接给你画删除线。新代码一律用上面的 Builder。不传参TokenTextSplitter.builder().build()就是全默认值。
参数怎么调?给个体感:
- chunkSize 太小(比如 200):一块装不下完整语义,"检索到半句话"等于没检索到
- chunkSize 太大(比如 2000):一块里混了好几个主题,向量被"平均"掉,检索精度下降,塞给 LLM 的 token 费也翻倍
- 经验区间:500-1000 起步,中文文档建议偏小(中文一个字约 1-2 个 token,比英文"稠")
坑 6:2.0 有个行为变更——token 数不超过 chunkSize 的小文本,不再在标点处切分(1.x 会切)。整篇短文就是一个块。这是官方故意改的,别当成 bug 去社区提问,会被老外围观。
三种切分策略
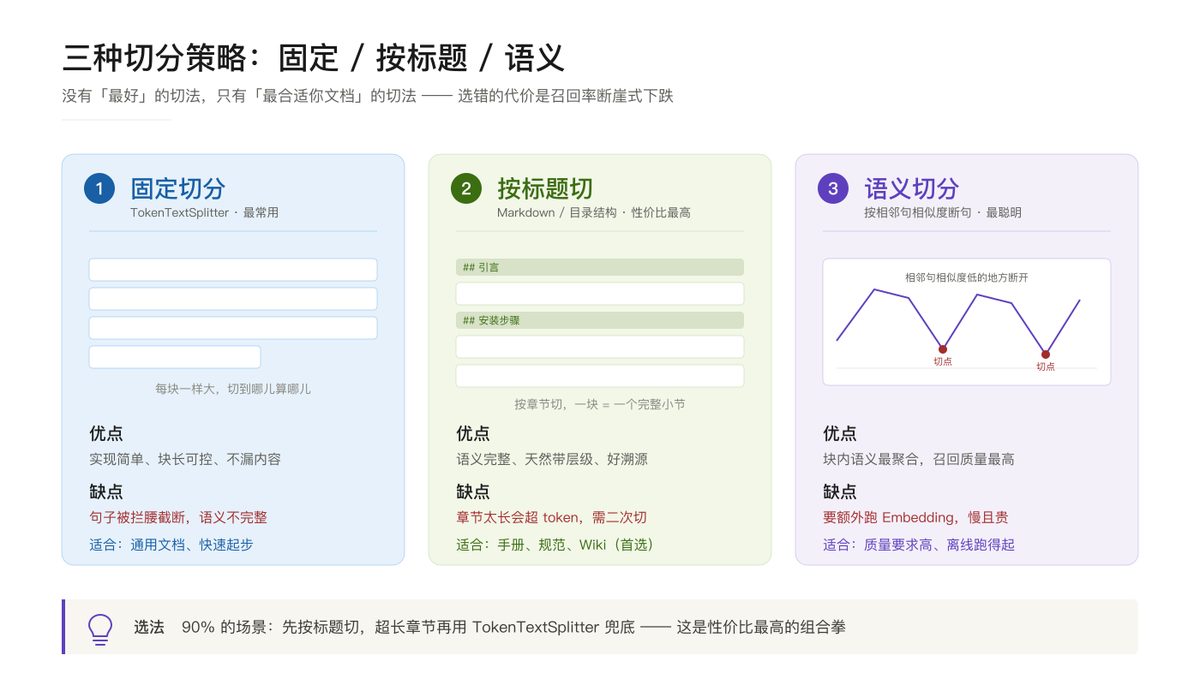
TokenTextSplitter 只是"固定切分"这一派。江湖上共有三派:
① 固定切分(TokenTextSplitter):每块一样大,切到哪算哪。简单、可控、不漏内容——但句子经常被拦腰截断。适合快速起步。
② 按标题切(Markdown / 目录结构):一块 = 一个完整小节。语义完整、天然带层级、溯源方便。手册、规范、Wiki 类文档的首选。
③ 语义切分:把相邻句子两两算 embedding 相似度,相似度"断崖"的地方切一刀。块内语义最聚合,召回质量天花板最高——但每个句子都要过一遍 Embedding,慢且贵,离线批量跑才划算。
我的建议写在图里了:90% 的场景,先按标题切,超长章节再用 TokenTextSplitter 二次兜底。这是性价比最高的组合拳,别一上来就整语义切分的花活。
三、两个致命坑:表格和代码块
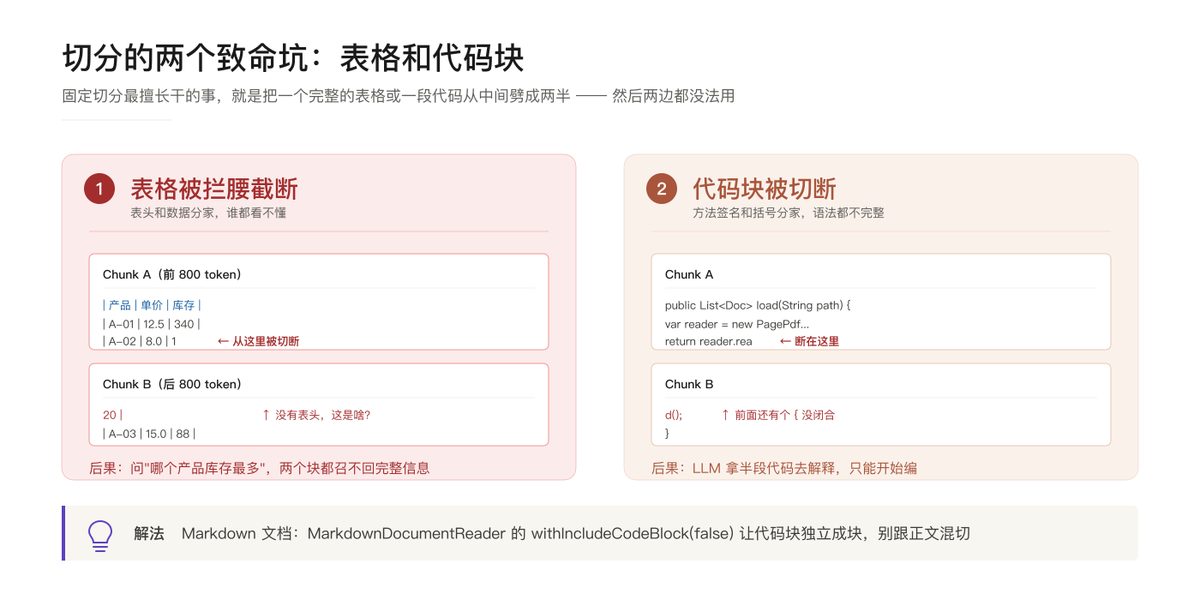
固定切分最擅长干的事,就是把完整的东西从中间劈成两半。最容易中招的是表格和代码块。
坑 A:表格被拦腰截断。 表头在 Chunk A,数据在 Chunk B。用户问"哪个产品库存最多"——A 有表头没数据,B 有数据没表头,两个块都召不回完整信息,LLM 只能开始编。
坑 B:代码块被切断。 方法签名和闭合括号分家,语法都不完整。LLM 拿半段代码去解释,编得比表格还起劲。
解法:让代码块独立成块
如果你的文档是 Markdown(技术团队的知识库大多是),有现成解法——MarkdownDocumentReader:
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-markdown-document-reader</artifactId>
</dependency>
MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder()
        // false = 代码块不跟正文混在一个 Document 里,独立成块
        // 切分只发生在标题处,代码块内部永远不会被劈开
        .withIncludeCodeBlock(false)
        .withIncludeBlockquote(false)  // 引用块同理,独立成块
        .withHorizontalRuleCreateDocument(true) // --- 分隔线也切一块
        .withAdditionalMetadata("source", "design-doc.md")
        .build();

MarkdownDocumentReader mdReader =
        new MarkdownDocumentReader("classpath:/design-doc.md", config);
坑 7(反直觉):
withIncludeCodeBlock(false)的意思不是"不要代码块",而是"代码块跟正文分家、各自独立成 Document"。传true才是"代码块和周围正文挤在一个块里等着被混切"。而且默认值就是 false——不少教程建议显式写出来,别赌默认值。
表格暂时没有这么贴心的开关(withIncludeTables 之类不存在于 Markdown reader),大表格的土办法:预处理时把表格转成"每行一句自然语言"("A-01 产品单价 12.5 元,库存 340 件"),一句话一个语义单元,怎么切都不散。
四、元数据:现在偷懒,将来流泪
切块时顺手把元数据补上,这是最容易被跳过、后面哭得最惨的一步:
Document doc = new Document("……正文……", Map.of(
        "source", "company-handbook.pdf",  // 来源:溯源展示用
        "version", "2026-09",             // 版本:知识库更新时按它删旧
        "tenant", "beijing-branch",       // 租户:多租户隔离过滤
        "updatedAt", "2026-09-09"         // 时间:权限/时效判断
));
为什么非要加?三个真实场景:
- 溯源:答案后面挂"出自 company-handbook.pdf 第 12 页",可信度完全不同
- 更新:手册改版了,按
source + version精准删旧插新,不用全库重灌 - 隔离:北京分公司的问答不能检索到上海分公司的制度——元数据过滤一把梭(第五篇细讲)
关键词和摘要这种要调 LLM 生成的元数据(KeywordMetadataEnricher / SummaryMetadataEnricher),每次跑都要花 token 钱——知识库百万字级时先算算账,别开箱就上。
五、串起来:一条能跑的 ETL 管道
三段拼装,一个方法搞定:
@Component
public class KnowledgeIngestion {

    private final VectorStore vectorStore; // 第五篇教你怎么配

    public void ingestMarkdown(String path) {
        // ① 读:Markdown 按标题成块,代码块独立
        MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder()
                .withIncludeCodeBlock(false)
                .withAdditionalMetadata("source", path)
                .build();
        List<Document> docs =
                new MarkdownDocumentReader(path, config).get();

        // ② 加工:超长块二次兜底
        List<Document> chunks = TokenTextSplitter.builder()
                .withChunkSize(800)
                .build()
                .apply(docs);

        // ③ 写:一把梭进向量库(内部自动做 embedding)
        vectorStore.accept(chunks);
    }
}
vectorStore.accept(chunks) 这一行内部会自动调 EmbeddingModel 把每块文本转向量再写入——你不需要手动 embed。这就是第①篇全景图里"离线索引"那条线的全部代码。
写在最后
这一篇是 RAG 的"地基篇":管道三段式、五参数、三派切法、两个致命坑、元数据四件套。切分决定天花板——地基打歪了,后面选型再豪华都是危楼。
下一篇《向量库选型与 PGVector 实战》:Milvus / PGVector / Redis / ES 到底选谁?Docker 五分钟起一个 PGVector,顺便填上今天埋的 initialize-schema 那个坑。
点个"在看"——垃圾进垃圾出这学费,咱们替读者交过了。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 4/10 篇 下期:向量库选型与 PGVector 实战