Java RAG 合集⑥:第一个能跑的 RAG——一行代码背后的五步
前五篇像不像在装修?第三篇把文字变成了向量,第四篇把文档切得干干净净,第五篇把 PGVector 跑通了——但每次检索,你都得手写 similaritySearch(),然后把结果手动塞进提示词,手动调模型。
这章开始,这些活框架全包了。一个 Advisor,五行代码,第一台整机下线。
读完你应该能:
- 用 QuestionAnswerAdvisor 五行代码跑通完整 RAG
- 搞清它背后替你干的五件事,以及 topK、阈值这两个旋钮怎么拧
- 知道默认提示词模板为什么中文项目必改,怎么改
- 让答案带上引用来源,而不是张嘴就来
- 想明白多个 Advisor 的执行顺序,别把安全护栏装反了
一、五行代码,第一个 RAG
先加依赖。注意模块名,2.0 改过了,网上老教程给的是错的:
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-vector-store-advisor</artifactId>
</dependency>
1.x 时代它叫 spring-ai-advisors-vector-store,2.0 拧了个词序变成 spring-ai-vector-store-advisor。照抄老教程,启动直接 ClassNotFoundException,报错信息还不会告诉你「是依赖名错了」。
然后是主角登场:
@Bean
ChatClient chatClient(ChatClient.Builder builder, VectorStore vectorStore) {
    return builder
        .defaultAdvisors(QuestionAnswerAdvisor.builder(vectorStore).build())
        .build();
}
调用侧什么都不用改,还是熟悉的 prompt().user().call():
String answer = chatClient.prompt()
    .user("年假可以跨年吗?")
    .call()
    .content();
就这些。第三篇的 EmbeddingModel、第四篇的切分结果、第五篇的 PGVector,全被这一行 .defaultAdvisors(...) 串起来了。
二、这行代码背后发生了什么
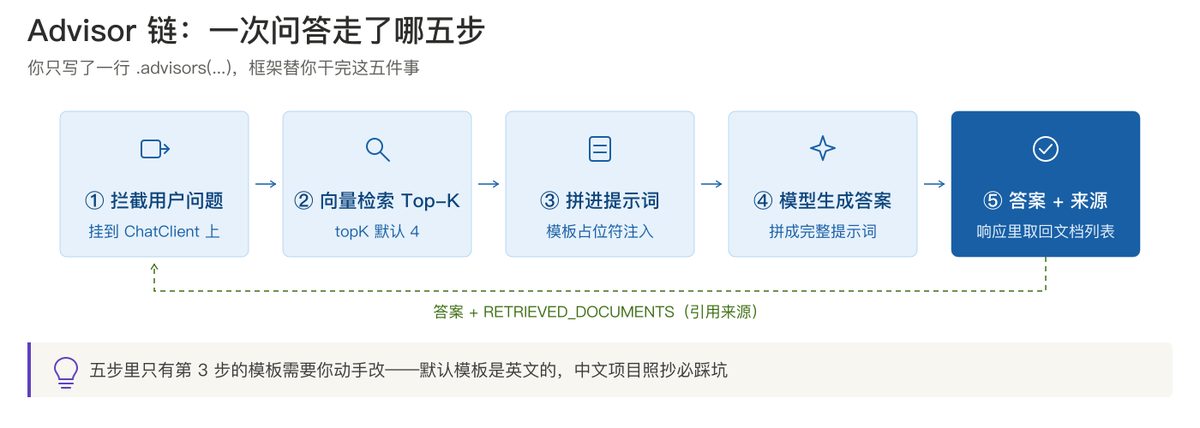
Advisor 是 Spring AI 的拦截器机制:每次 ChatClient 调用,都会先穿过一串 Advisor 再到模型。QuestionAnswerAdvisor 就是官方内置的那个「RAG 拦截器」,它在你毫无感知的情况下干了五件事:
- 拦截用户问题——你在
.user(...)里写的那句话,它先截下来 - 向量检索——拿问题去向量库做相似度搜索,默认取 topK=4 条
- 拼进提示词——把检索到的文档塞进模板的
{question_answer_context}占位符 - 交给模型——模型收到的是「system + 参考资料 + 问题」的完整三段式提示词
- 返回时顺路留痕——检索到的文档列表放进上下文,key 是
RETRIEVED_DOCUMENTS(第五节用它做引用溯源)
三、两个旋钮:topK 与 similarityThreshold
默认行为有两个地方几乎一定要调:
第一个坑爹默认值:similarityThreshold=0.0。 意思是「来者不拒」——哪怕检索回来的是八竿子打不着的文档,也照样塞进提示词。你问「年假跨年」,它给你塞一段食堂菜单,模型照样有模有样地「根据资料」回答。这是 RAG 幻觉的经典来源之一:不是模型在编,是你喂的资料本身就不对题。
第二个:topK=4。 不是越大越好。每多一条文档就多一份 token,账单变厚不说,无关内容还会稀释模型注意力。经验值:简单问答 4~6,复杂多跳问题再往上加。
调参写法:
QuestionAnswerAdvisor.builder(vectorStore)
    .searchRequest(SearchRequest.builder()
        .topK(6)
        .similarityThreshold(0.6)   // 0~1,低于此分数的不要
        .build())
    .build();
阈值怎么定?0.5 起步,太低(0.3 以下)等于没设,太高(0.8 以上)会把「换了种问法的正确答案」也拒之门外。这个值后面第九篇会用评测集科学地调,现在先拍脑袋定 0.6。
另外,过滤条件可以在运行时动态换——多租户场景刚需(租户 A 的员工只能搜到租户 A 的资料):
String answer = chatClient.prompt()
    .user("试用期年假怎么算?")
    .advisors(a -> a.param(QuestionAnswerAdvisor.FILTER_EXPRESSION,
                           "tenant == 'company-a'"))
    .call()
    .content();
这个 FILTER_EXPRESSION 的语法就是第五篇讲的跨库过滤表达式,一条都没变。
四、默认模板是英文的:中文项目必改
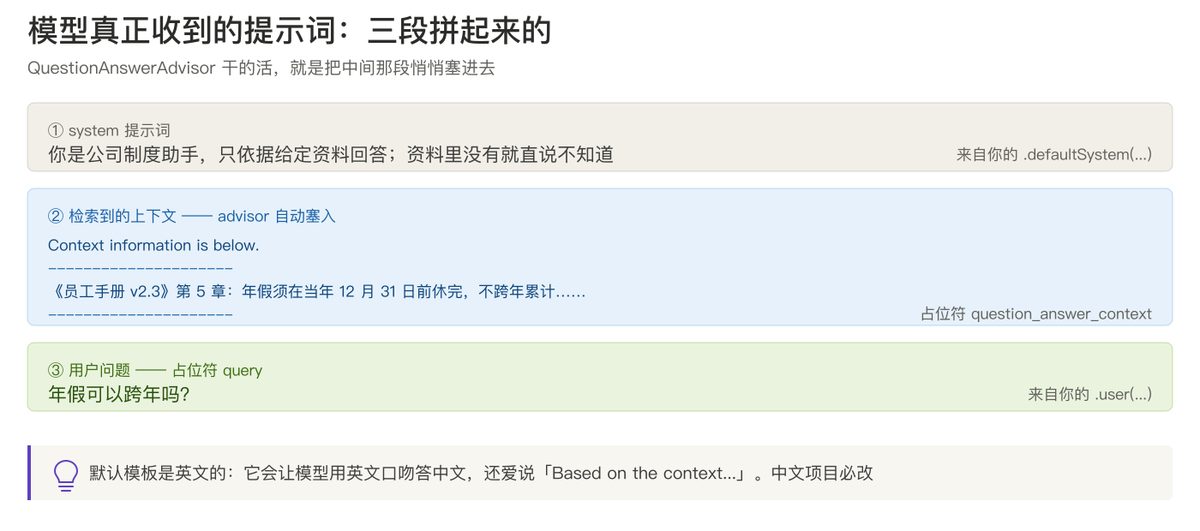
看这张图——QuestionAnswerAdvisor 拼出来的提示词,中间那段(检索到的资料)是模板生成的。默认模板是英文的,大意是「以下是背景资料,仅依据资料回答问题」。
用默认模板,两个后果:轻则模型时不时蹦出英文口吻的「Based on the context...」;重则在边界情况下用英文逻辑理解中文问题,答非所问。
改法是 .promptTemplate(),模板里必须保留两个占位符:{query} 收你的问题,{question_answer_context} 收检索结果,缺一个启动就报 IllegalStateException:
PromptTemplate zhTemplate = PromptTemplate.builder()
    .renderer(StTemplateRenderer.builder().build())
    .template("""
        请仅依据下面的参考资料回答问题。资料里没有的信息,
        直接回答「资料中没有」,禁止自行编造。

        参考资料:
        ---------------------
        {question_answer_context}
        ---------------------

        问题:{query}

        要求:
        1. 回答尽量精炼,先给结论再给依据
        2. 不要出现「根据上下文」「根据提供的信息」这类表述
        """)
    .build();

QuestionAnswerAdvisor.builder(vectorStore)
    .promptTemplate(zhTemplate)
    .build();
顺带说一句,这个模板本身就是防幻觉的一线阵地——「资料里没有就说没有」这句指令,比事后加护栏便宜一百倍。
五、让答案带上来源
企业场景里「答案从哪来」往往比答案本身还重要——员工要复核,法务要留痕。检索到的文档 QuestionAnswerAdvisor 都留了底,key 就是常量 RETRIEVED_DOCUMENTS,放在 advisor 上下文里。
自己写一个取来源的小 Advisor:
public class CitationAdvisor implements CallAdvisor {

    @Override
    public AdvisedResponse aroundCall(AdvisedRequest request,
                                      CallAdvisorChain chain) {
        AdvisedResponse response = chain.nextAroundCall(request);
        Object docs = response.context()
                .get(QuestionAnswerAdvisor.RETRIEVED_DOCUMENTS);
        if (docs instanceof List<?> list && !list.isEmpty()) {
            String sources = list.stream()
                .map(d -> (String) ((Document) d).getMetadata().get("source"))
                .filter(Objects::nonNull)
                .distinct()
                .collect(Collectors.joining("、"));
            log.info("本次答案来源: {}", sources);
        }
        return response;
    }

    @Override
    public String getName() { return "CitationAdvisor"; }

    @Override
    public int getOrder() { return 10; }
}
前提是第四篇里说的「元数据四件套」要好好写——source、version 这些字段当时嫌麻烦,现在取来源就靠它。把 log.info 换成把来源列表写进响应对象,就是最朴素的「答案 + 参考文档列表」界面。
六、多个 Advisor 谁先谁后:栈式执行
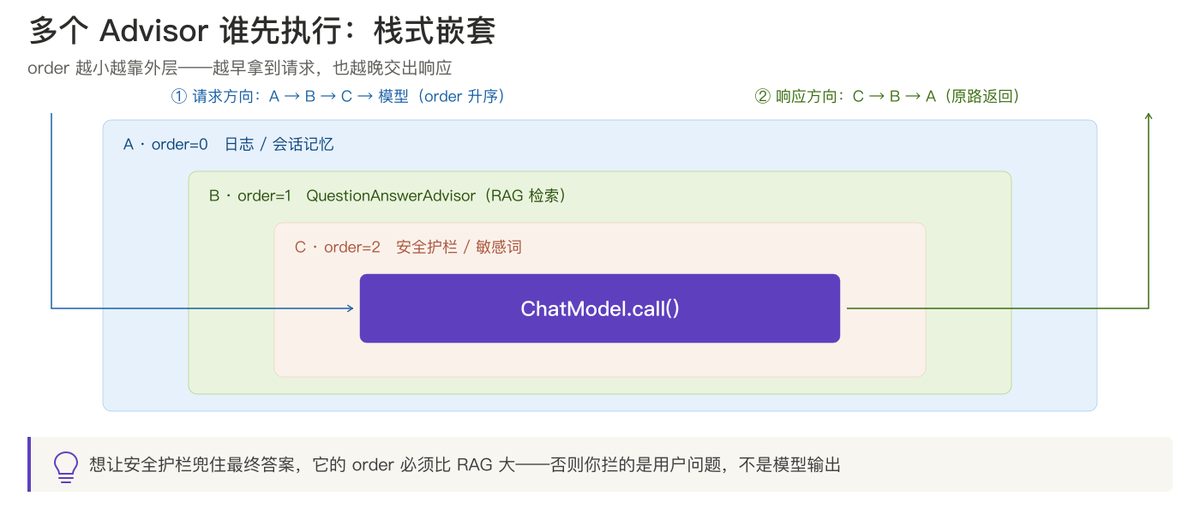
真实项目里不会只有一个 Advisor:日志、会话记忆、RAG 检索、安全护栏……每个都有一个 order 值,规则一句话:order 越小越靠外层,越早处理请求、越晚处理响应,整条链像栈一样先进后出。
QuestionAnswerAdvisor 默认 order=0,也就是默认最靠外。这带来一个隐蔽的坑:你想加一个敏感词护栏,把 order 也设成了 0 或负数——恭喜,你拦的是用户的问题,而不是模型的回答。 护栏要兜住最终输出,order 就必须比 RAG 大,让它待在内层。
常见排布(记不住就收藏这张图):
- order 最小(外层):日志、会话记忆——它们要看到最原始的输入
- 中间:RAG 检索
- order 最大(内层):安全护栏、引用溯源——它们贴近模型输出
七、坑位清单
- 坑 1:依赖名抄了老教程。
spring-ai-advisors-vector-store是 1.x 的名字,2.0 是spring-ai-vector-store-advisor。启动报ClassNotFoundException先查这个。 - 坑 2:自定义模板丢了占位符。
{query}和{question_answer_context}缺一个就IllegalStateException。改模板是在默认版基础上改措辞,不是推倒重写。 - 坑 3:阈值懒得设。 默认 0.0 来者不拒,不相关文档照样进提示词——很多「RAG 答非所问」的案子,凶手是它不是模型。
- 坑 4:默认模板是英文。 中文项目必改,理由见第四节,不重复。
- 坑 5:护栏 order 随手写。 比 RAG 小 = 拦问题;比 RAG 大 = 拦输出。想清楚你到底要拦哪个。
八、完整可跑的 Controller
把上面的零件装到一起:
@Configuration
class RagConfig {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder, VectorStore vectorStore) {
        return builder
            .defaultSystem("你是公司制度助手,只依据给定资料回答。")
            .defaultAdvisors(
                QuestionAnswerAdvisor.builder(vectorStore)
                    .searchRequest(SearchRequest.builder()
                        .topK(6)
                        .similarityThreshold(0.6)
                        .build())
                    .promptTemplate(zhTemplate())   // 第四节的中文模板
                    .build(),
                new CitationAdvisor()               // 第五节:order=10,取来源
            )
            .build();
    }
}

@RestController
@RequestMapping("/qa")
class QaController {

    private final ChatClient chatClient;

    QaController(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    @GetMapping
    String ask(@RequestParam String q) {
        return chatClient.prompt().user(q).call().content();
    }
}
跑起来,浏览器里敲 localhost:8080/qa?q=年假可以跨年吗——如果返回的是员工手册里的答案而不是模型的胡说八道,恭喜,你的 RAG 上线了(开发环境意义上)。
写在最后
第一个整机跑通了,但你也应该隐约感觉到它的糙:查询改写没有、多轮对话的指代(「那深圳呢?」)理不清、空上下文直接硬答。这些糙点就是下一篇的活儿。
下一篇《模块化 RAG:RetrievalAugmentationAdvisor》——把 RAG 拆成四段可插拔的流水线:查询改写让多轮对话准确率涨三成,多查询扩展一次搜三个角度,空上下文优雅兜底。零件齐全之后,才轮到调优。
点个「在看」——第一个能跑的 RAG,一行代码背后是五步,五步背后是前五篇。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 6/10 篇 下期:模块化 RAG:RetrievalAugmentationAdvisor