阿里开源内部代码审查工具,token 只用 1/9
先说个几乎每个写代码的人都遇到过的场景。
你把一段改动丢给 AI,说「帮我看看有没有问题」。它认认真真回你三条意见,措辞专业,看着都挺像回事。等你真去改,发现它说的第 47 行,那边是一片空行。
这时候大多数人的反应是:AI 还是不行。
但这个判断可能下早了。问题不在于它笨,在于它不知道该看哪。
AI 审代码,卡住的不是「看不懂」
阿里这次开源的时候,把通用 AI 智能体做代码审查的三个老毛病写进了文档,翻译成人话是这样:
一是覆盖不全。改动一多,它就「偷懒」,只挑几个文件看,剩下的悄悄跳过。你以为审了全部,其实只审了一部分。
二是位置漂移。它说有问题,但报的行号、文件名常常跟实际对不上。你还得自己再去定位一遍。
三是质量不稳。同一段代码,问法稍微变一下,结论就变。今天说没问题,明天说很严重。它不是撒谎,它是真的每次都在重新猜。
文档里有句话说得挺不客气:纯语言驱动的架构,对审查过程没有任何硬约束。
打个比方。这就像一个特别聪明、特别能聊、但从来不按检查清单来的医生。他能跟你聊半小时作息和压力,聊得你频频点头,但血常规没查、心电图没做。等你回家才发现,真正的问题一个没查出来——不是他不会看,是他没看。
代码审查这活儿,最怕的恰恰就是这个:漏。
阿里把自己用了两年的工具开源了
9 月中旬,GitHub 上一个叫 open-code-review 的项目冲上了每日趋势榜,短短几天 star 数涨到 3 万以上(公开榜单口径)。Apache-2.0 协议,用 Go 语言写的,79 位贡献者。
它的来历和那些「为了开源而造」的项目不一样。
按仓库自己的说法:它原本是阿里巴巴内部官方的 AI 代码审查助手,两年时间里服务了数万名开发者,识别出数百万个代码缺陷(据官方 README 口径)。两年之后,团队才把它整理成一个开源项目放出来。
一个工具能在阿里那种体量的代码库里、在真实的业务压力下活满两年,这件事本身比任何宣传都硬。
它内置的规则集覆盖四类老毛病:空指针、线程安全、跨站脚本(XSS)、SQL 注入。
这四样听着不新鲜,但每一样都能让你半夜被叫起来。空指针会让服务直接崩;线程安全的毛病偶发到你根本复现不出来,只能靠猜;后两个是最常见的网站漏洞,攻击者最喜欢。
最关键的设计:它不让 AI 干全部的活
这是整件事最有意思的地方。
一个 AI 工具,主动限制 AI 的使用范围。
它把审查这件事拆成两半。
第一半,交给不会出错但不够灵活的传统工程逻辑。这部分是硬约束,由代码规则保证,不由模型自由发挥:
- 哪些文件必须审、哪些该过滤掉,由规则定,不让模型自己挑;
- 相关文件捆成一组一起看——比如中英文两份配置必须同步改,就把它们绑成一个审查单元,各组独立开一个「分身」,互不干扰,改动再大也不会顾此失彼;
- 按文件特征匹配对应的规则,而不是把一大堆无关信息全塞给模型;
- 还专门做了两个独立模块,一个负责校正问题所在的位置,一个负责反思评论内容,分别治「行号报错」和「话说得太满」。
第二半,才交给 AI。
它只干自己最擅长的事——需要动态判断、动态找上下文的部分:读完整文件、在代码库里搜索相关代码、参考其他被改动的文件。
而且它的提示词和工具集都是专门为代码审查调过的,不是把通用工具箱直接搬过来。
还是用体检打比方。血常规、心电图这类有标准答案的检查,交给机器——一秒出结果,不会看走眼,也不会漏项。真正需要综合判断的那部分,比如你最近老失眠到底是压力还是别的,才交给医生慢慢聊。
这两件事混在一起做,才会出问题。分开做,各自发挥。
效果:同一个模型,token 只用约 1/9
设计说得好听不算数,看数据。
阿里拿这套工具和通用智能体做了实测,用的是同一个底层模型——这一点很关键,排除了「换个更强的模型所以更好」的可能。结果:
- 精确率(报出来的问题里有多少是真问题)和综合的 F1 值,明显更高;
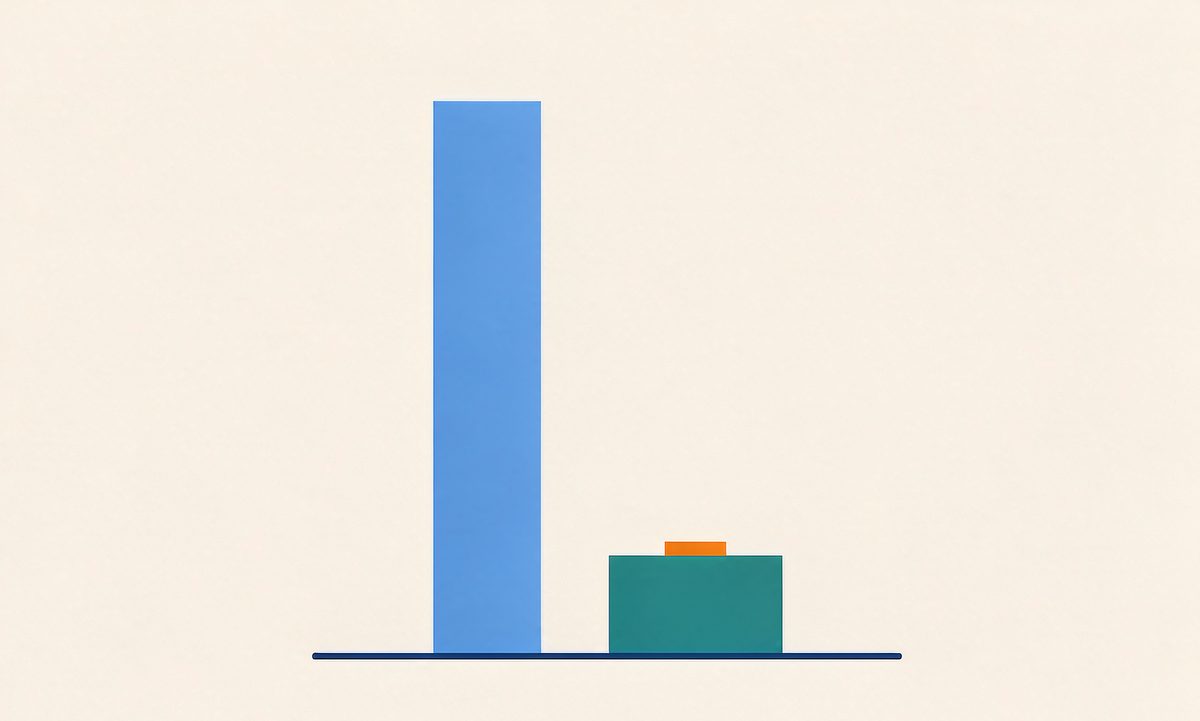
- token 消耗约为通用智能体的 1/9,也就是成本降到大约九分之一;
- 单次审查耗时更短。
还有一个官方明说的取舍:它的召回率(真存在的问题里被揪出来多少)比通用智能体低。
这不是失误,是主动选择——宁可少报,也不报一堆假的。
对管团队的人来说,这一条比前面几条都重要。因为一个审查工具最大的死因从来不是漏,是烦。它要是天天给你报十条假警报,第三天全组就没人点开看了,工具等于白装。
测试集也不是随便凑的:从 50 个热门开源仓库里挑了 200 个真实提交,覆盖 10 种编程语言,由 80 多位资深工程师交叉验证,标出 1505 条标准答案。这套数据集也一并公开了。
一个容易被忽略的细节
代码审查工具有个天然属性:它得读你的整个代码库,才能给出有上下文的意见。
换句话说,它能看到什么,就能把什么发出去。
9 月 16 日发布的 v1.12.3 版本,专门补了两件事:把密钥相关的路径排除在审查范围之外,把各个环境用的 .env 文件保护起来。
这类文件里通常躺着账号、密码和接口密钥。以前它们可能跟普通改动一样,被原样送进审查流程。
同一版还修掉了一个路径穿越的问题,防止工具被诱导去读本不该读的文件。
这给所有要采购 AI 工具的人提了个醒:谈的时候别只问「它能不能看懂我们的代码」,接着要问一句——「它能把哪些东西发到外面去,这个清单在哪。」
所以,这件事跟不写代码的你有什么关系
三个可以带走的判断。
第一,AI 工具正在从「越自动越好」转向「分工越清楚越好」。
2024 到 2025 年那一波,主打的是「全交给大模型」,演示都很惊艳,真用起来都不太稳。2026 年的做法变了:能用确定性规则保证的事,就不交给模型。
这不是 AI 退步,是工程成熟——先想清楚模型会在哪儿飘,然后把那一块收回来。
第二,商业代码审查工具的定价空间会被压。一个免费、可以自己部署、还经过大厂两年真实业务验证的工具摆在这儿,付费工具的溢价就不好讲了。对企业是好事,对做这块的创业公司是实打实的压力。
第三,判断一个 AI 工具靠不靠谱,看它敢不敢承认短板。这个项目在文档里写得明明白白:召回率比通用智能体低。一个愿意把短处写进说明书的工具,比一个只讲优点的工具值得信任。
最后
AI 帮我们省事,最好的方式往往不是让它包干一切。
而是想清楚哪一部分它有把握、哪一部分它容易飘,然后把容易飘的那块收回来,交给更笨但更可靠的办法。
会分工的,才是真省事。
如果你也在琢磨 AI 工具到底该怎么用、哪些是真省事哪些是白折腾,可以关注我。我尽量只写有数据、能落地的东西——不写「XX 太可怕了」那种。