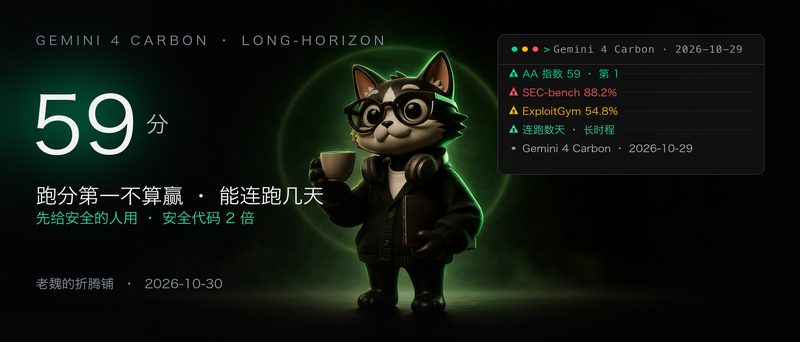
跑分第一不算赢,跑得久才算
AI 模型 · 长时程赛道 | 2026-10-30 | 59 分第 1 · 连跑数天 · 安全代码 2 倍 · 先给安全的人用 | 数据来源:Google 官方博客 + 凤凰网科技
你的 agent 接了个「把全仓库的安全隐患找出来、验证、再修掉」的活。干到俩小时,上下文爆了。你只能把它拆成二十个小步,手动一把一把喂进去;第二天醒来一看,它第七步就摆烂了——「任务太长,建议人工介入」。
这事儿,Google 说它能解决。 10 月 29 号它放了个新模型,叫 Gemini 4 Carbon。名字听着像跑车零件,干的是「能连跑几天的活」。
PART 01 · THE SCORE · 跑分第一
先上数据。Artificial Analysis 智能指数更新到 v5.0,Carbon 拿了 59 分,排第 1。WebDev Arena 上 1768 分,升到第 4,Elo 一口气涨了 89。
但有个限定得说清楚:这些分是没开安全防护跑出来的。 所以「59 分第 1」是裸考成绩,不是「戴着安全帽还能跑第一」。真拿它上生产,得再看一遍带上防护的分。
PART 02 · ENDURANCE · 跑得久才是重点
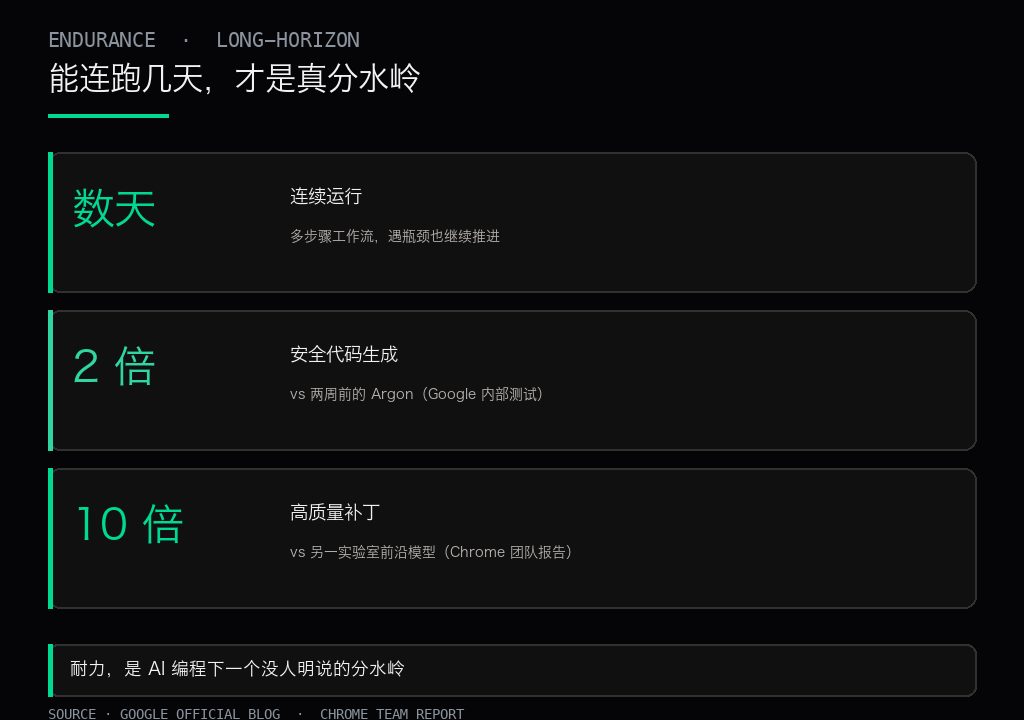
跑分第一不是重点,重点是它能连跑几天。Google 的说法:面向执行周期更长、复杂度更高的工程任务,可以连续运行数天,持续处理多步骤工作流,遇到瓶颈也接着推进,而不是撂挑子。
这就戳中你那个老痛点——agent 干到一半就「累」了。你见过这种场景吧:改到一半上下文窗口满了、工具超时了、或者它干脆回你一句「这活超出我的能力范围」。Carbon 是冲着「把长活干完」去的,不是冲着「单步更快」去的。方向不一样,这比涨两分值钱。
说白了,AI 编程卷到现在,单步生成早就够了,卡的是耐力。你真正缺的不是一个能写 50 行函数的模型,是一个能在深夜里替你盯完整个活、不睡着的模型。
内部测试里,它生成安全代码的成功率比两周前的 Argon 高了 2 倍不止;Chrome 团队的报告更狠——生成高质量补丁的表现,比另一家实验室的前沿模型好 10 倍以上。
PART 03 · WHO FIRST · 先给谁用
最反常识的一点:这模型不先给开发者,先给安全防御者。 开放节奏是——先给部分网络安全防御人员,再通过 Fairwind 计划扩到可信合作伙伴,最后才轮到开发者、企业、普通消费者。
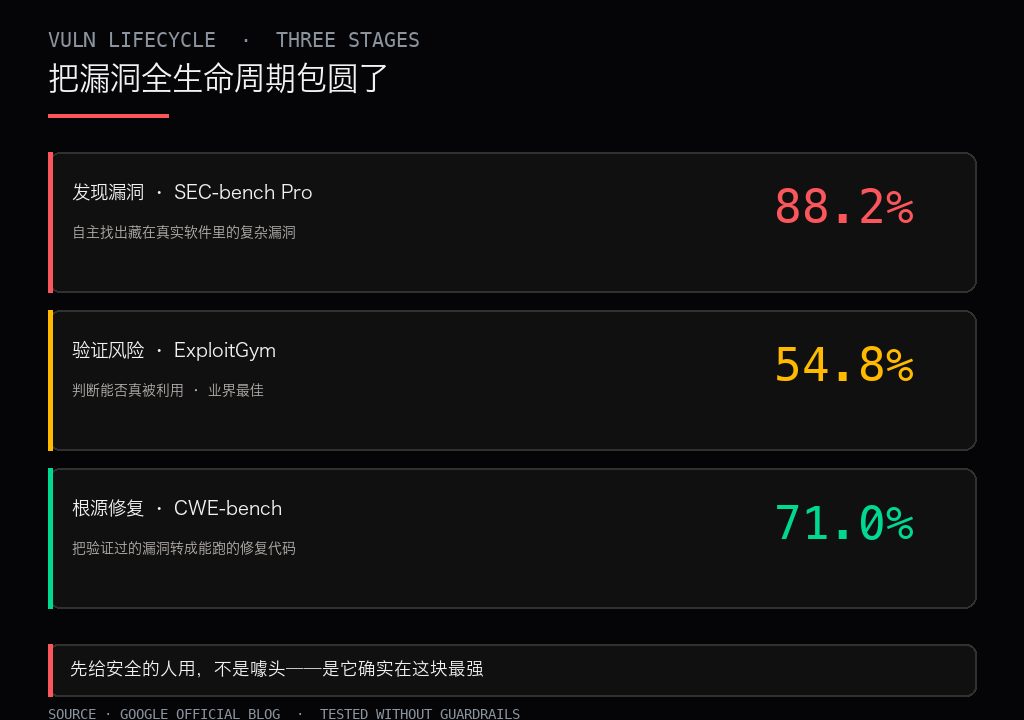
因为它把「漏洞全生命周期」包圆了: - 发现漏洞:SEC-bench Pro 88.2%,能自主找出藏在真实软件里的复杂漏洞 - 验证风险:ExploitGym 54.8%,判断漏洞能不能真被利用,业界最佳 - 根源修复:CWE-bench 71.0%,把验证过的漏洞直接转成能跑的修复代码
Wiz 也观察到它在 Web 渗透测试基准上领先。所以「先给安全的人用」不是噱头——是它确实在这块最强,先给最需要的人。
PART 04 · PRICE · 值不值
价格跟 Argon 一样:每百万输入 token 2 美元、输出 10 美元,缓存输入打 95 折。 没涨价,但也没便宜——它是拿「耐力」换溢价,不是拿「低价」抢市场。
CASE 01|深夜挂个长任务
需求:你是个 1-5 年经验、代码库历史包袱重的程序员,想修一批已知安全隐患,但白天没整块时间,任务要跨几小时甚至一夜。
方案:1. 晚上收工前,把「找出全库漏洞根因并修复」的任务挂给 Carbon 类长时程模型。2. 设好验证基准(跑测试 + 扫差异),不打断它。3. 第二天看结果,只人工复核高风险改动。
输出:- 长任务有人接了,不用拆成小步手动喂;- 验证基准兜底,模型「摆烂」能被测出来;- 风险集中在一处,人工复核成本可控。
PART 05 · 一句话结论 · 别只盯跑分
一句话推荐: 别只盯跑分排行榜——能连跑几天的模型,才配得上「长时程任务」这四个字。
适合场景:- 那种一挂就要几小时甚至几天的活——全库漏洞根因排查、大重构、长链路回归;- 以前没人敢交给 agent,现在模型说它接得住;- 想拿「长时程」当新维度去挑模型,而不是只看 AA 榜。
参考资源:- Google 官方博客《Gemini 4 Carbon 发布》(2026-10-29);- 凤凰网科技 2026-10-29 报道(含基准未开防护的限定);- Artificial Analysis 智能指数 v5.0(59 分第 1 出处)。
最后毒舌一句:Google 这波聪明在——它不跟你卷「谁的模型单步最强」,它卷「谁的模型能陪你熬夜」。耐力,是 AI 编程下一个没人明说的分水岭。