半价打平 Claude,那 2 分是这么来的
AI TOOL · 实战拆解 | 2026-10-29 | 每任务成本 $5.59 vs $11.42 · 60 vs 62 · 7.2M tokens/任务
GitHub 上周三(10-28)把 Copilot Fusion 转正了,一句话总结:不用你选模型了,Copilot 替你选,还能省钱。 官方口径是「Fusion Max 在 Artificial Analysis 的 Coding Agent Index 上得 60 分,只比 Claude Code + Opus 5.5 Max 低 2 分,但每任务成本大约一半,token 大约一半,时间省约 40%。」听起来像捡钱。我先把这钱到底是谁省的、怎么省的拆一遍,结论先说:这 2 分是「打平」的包装,不是「打平」的证据。
PART 01 · 半价打平 · 先看数字再鼓掌
「打平」靠的是 2 分,但 AA 指数的 2 分不是误差,是「不均衡」。
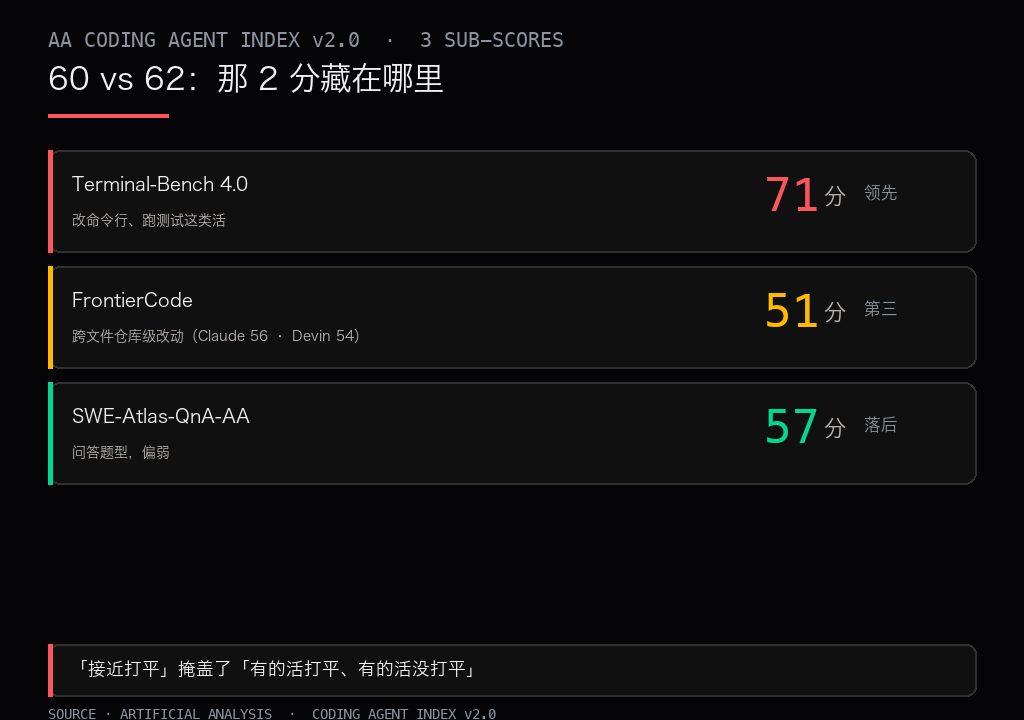
先摆第三方数据。Artificial Analysis(后面简称 AA)的 Coding Agent Index v2.0 加权三个评测等权:Terminal-Bench 4.0、FrontierCode、SWE-Atlas-QnA-AA。Fusion Max 总分 60,Claude Code + Opus 5.5 Max 是 62。但拆开看就露馅了:
- Terminal-Bench 4.0:Fusion 71,领先。
- FrontierCode:Fusion 51,第三(Claude 56、Devin Fusion 54)。
- SWE-Atlas-QnA-AA:Fusion 57,落后。
2 分的差距不是均匀分布的,是「终端任务强、仓库改造弱」。 换句话说:Fusion 在改命令行、跑测试这类活上确实猛,可一旦是跨文件的仓库级改动(FrontierCode 就是干这个的),它反而掉队。「接近打平」这个说法,掩盖了「有的活打平了,有的活没打平」。 你选 Fusion 之前,先想想自己每天写的是哪种活。
顺带说一句:AA 自己也提醒过,个位数的分差要谨慎对待——指数是加权合成的,一个子项被拉高,总分就会好看,不代表全面。所以「60 只差 2 分」这句,在 AA 眼里是「接近但不等同」,在 GitHub 的宣传里是「打平」。同一个数,两种读法,你选哪种?
PART 02 · 省钱从哪来 · 路由便宜模型
Fusion 省的不是模型钱,是「把简单活派给便宜模型」的钱。
GitHub 官方说得很清楚:Fusion 不是模型,是运行时路由 + 编排器(GitHub CPO Mario Rodriguez 对 VentureBeat 原话:「It's not a model. It's an orchestration engine at runtime.」)。你只挑一个 effort 档(Standard / High / Max),Fusion 每任务自己决定用哪个模型、用几种模式:
- Single:一个模型直接干。
- Cascade:便宜模型起草 → judge 判断要不要升级到强模型。
- Critique:模型 A 起草 → 模型 B 批判 → A 照着改。
省钱机制就在这:简单任务走 Cascade,便宜模型一把过,根本不惊动 Opus 5.5。 这就是为什么 token 只有 7.2M/任务(约 Opus 5.5 的一半)——省的不只是单价,是少干了活。AA 测算也印证:成本优势「部分来自做了更少的模型工作,不只是用了更便宜的 token」。
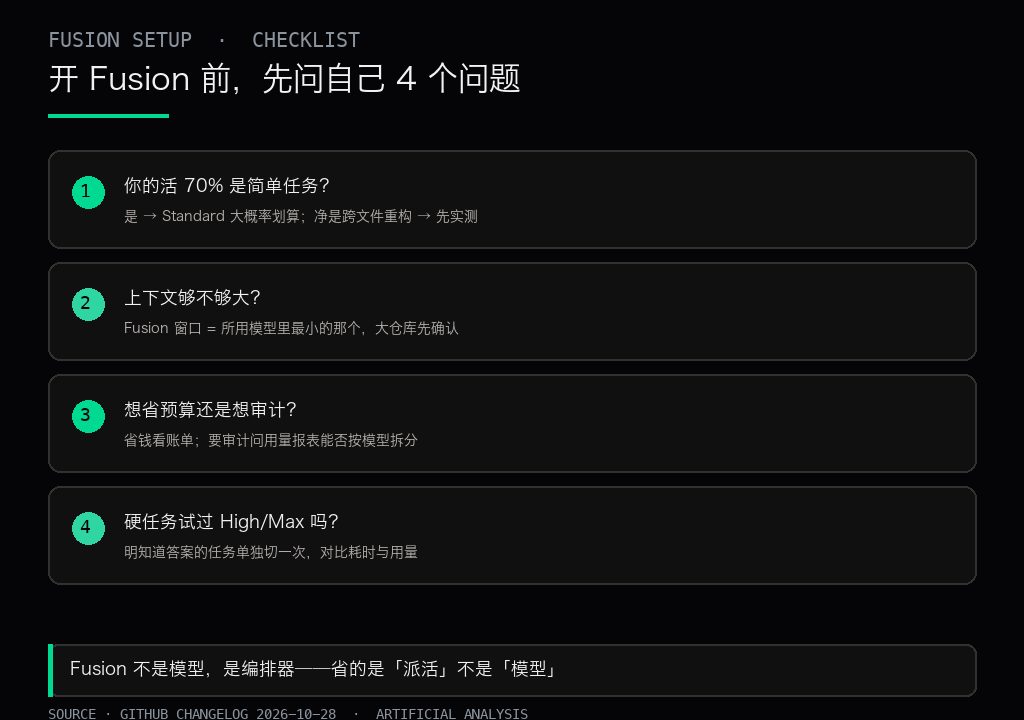
但代价是:如果任务难到每步都得用最强模型,Cascade 会在 judge 判断后不断升级,最后可能比直接上强模型还贵。 省钱的假设前提是「大部分活便宜模型能接住」——你的仓库如果净是硬骨头,这个前提不成立。还有:Fusion 没有自己的上下文窗口,显示的是它所用模型里最小的那个。 你的仓库如果上下文很大,先确认 Fusion 调用的模型装得下。
那 Fusion 到底用哪些模型?AA 实测在 Fusion 的池子里看到了 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol,具体用哪个随任务和组织策略变。模型切换发生在缓存边界,避免额外缓存费用;简单任务会跳过审查调用。 所以它不是「固定某个模型」,是「一任务一组合」。
PART 03 · 自报 vs 第三方 · 口径要分清
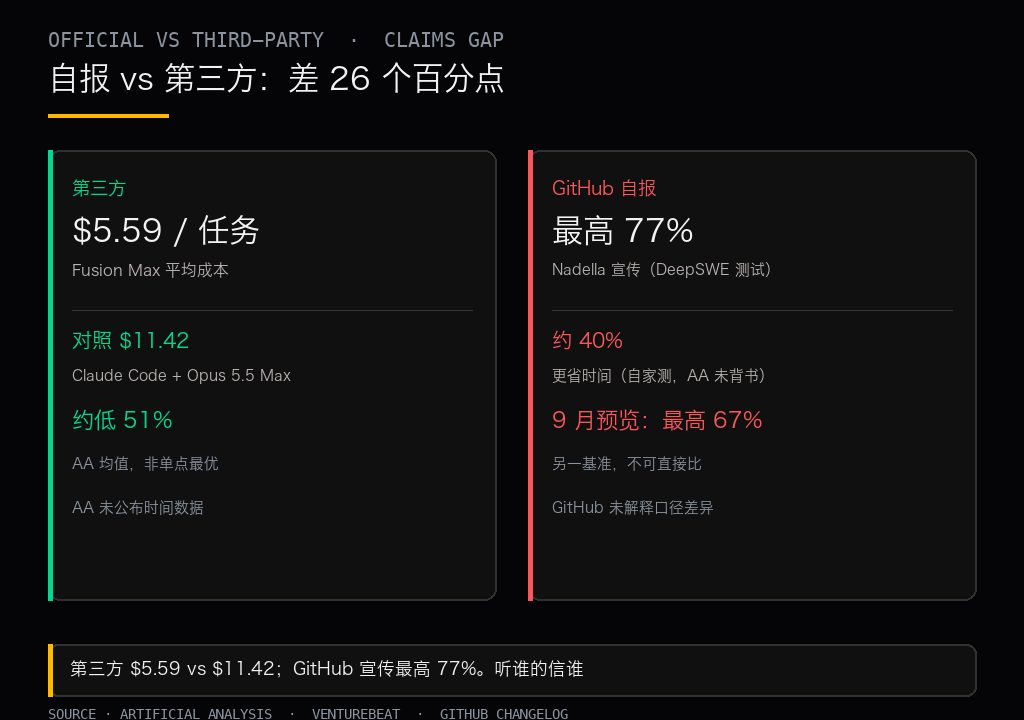
「40% 更省时间、最高 77% 更省钱」这两个数,是 GitHub 自报的,不是 AA 测的。
这里要较真一下,因为这是最容易看走眼的地方:
- 「约 40% 更省时间」:GitHub changelog 里写的。但 VentureBeat 明确指出 AA 的文章根本没有公布时间数据,所以 40% 是 GitHub 自家测的,第三方没背书。
- 「最高 77% 更省」:是 Satya Nadella 亲自宣传的数,但它来自 GitHub 自家的 DeepSWE 测试(不同测试条件),不是 AA 的平均值。AA 均值是「约一半」($5.59 vs $11.42,约 51% 更低)。
- 还有个小背景:9 月 HydraFusion 预览时 Nadella 说过「最高 67% 降本」(终端基准),现在正式版换成了「约 50% 降本」(另一个基准)。两个数不是一回事,GitHub 也没解释差在哪。
第三方测的是 $5.59 vs $11.42;GitHub 宣传的是最高 77%。差 26 个百分点。 你听谁的就信谁。我只认第三方,且只认「每任务平均成本」。AT&T 首席软件工程师 Hari Pokhrel 在 changelog 里说 Fusion Standard「提升了 token 效率、减少了不必要支出」——这是客户证言,但没有数字,只能当方向看,不能当证据。
PART 04 · 账本变了 · 成本单位从 token 变成「每完成一件活」
这才是真正值得记下来的变化:计费口径从「用了多少 token / 什么模型单价」变成「干完一件活花了多少」。
以前你算 Copilot 成本是「这个月烧了多少 token × 单价」;Fusion 直接把答案换成「干完一个任务平均 $5.59」。这是把「成本」从资源度量变成了交付度量——你买的是「把活干完」,不是「token」。这对企业采购是质变:以前比模型单价,现在比每件活的成交价。
同时计费方式也值得注意:
- 无独立 Fusion 费,按每个实际调用模型的标准费率计费。
- 付费计划 30% 折扣到 2026-11-30(这跟上面的基准节省是两码事,别叠加算)。
- Fusion High/Max 一任务可能调多个模型 → 单任务 AI credits 可能比 Standard 更多。 Critique 模式要付第二模型的钱,别天真以为选了 Fusion 就一定便宜。
对照一个数字:Devin Fusion(Opus 5.5 Max + GPT-6 Luna High)得 62 分,每任务 $8.00——比 Fusion 贵 43%,分数反而高 2 分。这不是「Fusion 更划算」的证明,是「编排本身有性价比曲线」的证据:不同编排引擎、不同模型池,产出不同的「分数/美元」。 你真正要比较的不是「Fusion 和 Claude 谁好」,是「谁的编排 + 谁的模型池,给你最优的分数/美元」。
还有个容易被忽略的点:GitHub 这次把 GitHub Enterprise 也并进了 Copilot——大客户从第一请求起就按企业 AI 预算计量,没 Enterprise 许可证的拿 Copilot Standalone $10/人/月。「每任务成本」这套账本,正在从工具层爬上采购层。
而 Claude Code 走的是另一条路:它绑定自家模型(Opus/Sonnet),靠「模型 + harness 同厂调优」打质量,不跟你玩跨厂商编排。两条路线谁赢,取决于你更信「一个厂商把模型和工具捏在一起」,还是「把别家模型编排起来的灵活性」。 这不是谁对谁错,是两条不同的价值主张——Fusion 已经把话说死了:它不生产模型。
PART 05 · 怎么用 · CASE 上手
CASE 01|要不要开 Fusion,先看你的活长啥样
需求:你是个 1-5 年经验的程序员,纠结要不要把默认模型换成 Fusion。
方案:1. 先摸清自己仓库:大部分是改命令行、跑测试、小修小补,还是跨文件大重构?2. 开 Fusion Standard 跑一周,对比你原来的默认模型,看完成质量和 AI credits 消耗。3. 遇到一个你「明知道答案」的硬任务,单独切 Fusion High/Max 试一次,看结果、耗时、用量和你平时差多少。4. 看账单前后差异,再决定要不要长期用。
输出:- 轻改小修为主 → Standard 大概率划算;- 净是跨文件重构 → 先实测再定,别迷信「半价」;- 想要审计 → 问你的 GitHub 联系人,用量报表能不能按模型拆分(Fusion 没公开每次路由的 trace,发票是最可靠的记录)。
CASE 02|企业管理员怎么控
需求:你是团队管理员,怕 Fusion 把代码发给公司没批的模型。
方案:1. 检查企业/组织模型策略,Fusion 只从启用的模型里选。2. 可仅为 Fusion 禁用某个模型(不影响 Copilot 其他地方用)。3. 可设任意 effort 档为 Copilot 默认模型(Enterprise managed settings)。
输出:- 模型池可控;- 审计靠账单,不靠界面。
PART 06 · 一句话结论 · 别数模型,数活
一句话推荐: Fusion 值得开,但把它当「省钱的编排器」,别当「打平 Claude 的模型」。
适合场景:- 你的活 70% 是简单任务,想省 AI 预算;- 你受够了手动切模型、切了又忘切回来;- 你想把「AI 成本」从 token 账本改成「每任务账本」。
参考资源:- GitHub changelog(2026-10-28,Copilot Fusion 转正);- Artificial Analysis Coding Agent Index v2.0(第三方分数与成本);- VentureBeat 对 GitHub CPO Mario Rodriguez 的采访(「编排引擎」原话出处)。
最后毒舌一句:GitHub 赌的不是「自己模型最强」,是「把别家的模型编排得最好」。这招够狠——反正 Opus 5.5 不是它家的,它不生产模型,它生产「把活干完的性价比」。