上一篇我让 AI 画了个古装美人,它回手给我一张麻子脸。
那篇发出去之后,被问得最多的是另一件事:修好脸之后呢?
说实话,修脸只是热身。真正让人崩溃的是下一步——你怎么让这张脸,出现在六个完全不同的场景里,还是同一个人。
我试了。第一次的答案是:做不到。
一、先看翻车现场
同一段人设文字,同一个模型,我生成了三张场景图——宫廷宴会、月下听松、书斋作画。
单看每一张,都挺好看。
把脸裁出来并排放,就不是那么回事了:
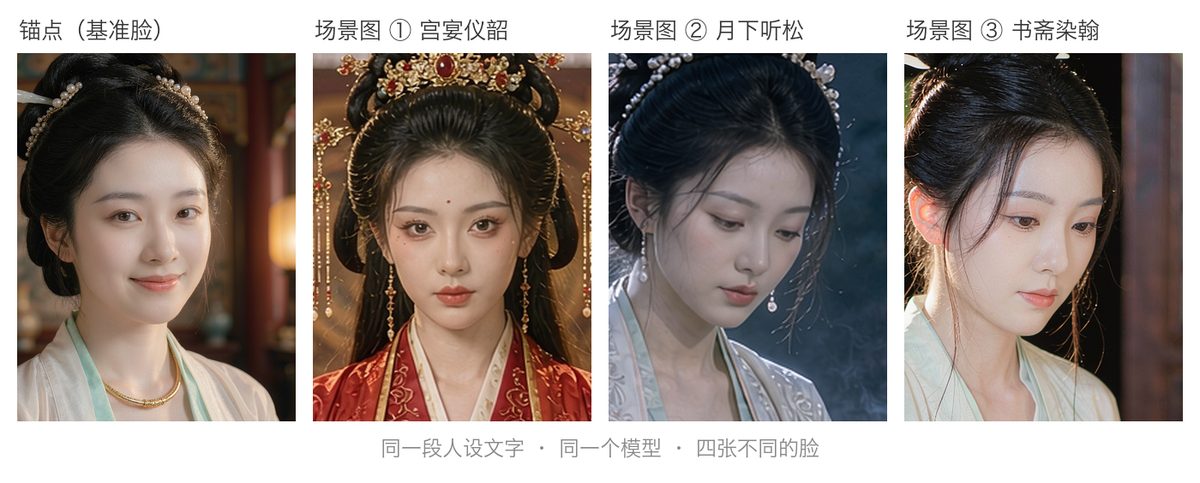
最左边那张是"锚点",也就是我认可的那张定妆照。右边三张是场景图里的脸。
第二张(宫廷宴会)的脸明显更尖、眼角更利,额间还凭空多了个花钿——我从来没写过"花钿"这两个字。第三张、第四张更离谱,从发髻到脸型都不是一个人。
这就是换脸漂移。它不报错,不弹窗,不给你任何提示。它只是安静地、礼貌地,交给你三个长得像的陌生人。
二、为什么用文字锁不住脸
先说清楚根子在哪。
我一开始的思路,和大多数人一样:把描述写细一点。
脸型写成鹅蛋脸,眼睛写成杏眼,眉毛写成远山眉,鼻子写成……写到我自己都觉得像在报案。
没用。
因为文字描述是概率性的。
你写"杏眼",模型理解的是一个范围——而它在画每一张新图的时候,都会在这个范围里重新掷一次骰子。上一张掷出杏眼 A,这一张掷出杏眼 B,你看到的就成了"眼睛好像哪里不一样了"。
你写得再细,也只是把骰子的范围缩小。范围永远不等于一个点。
一篇几百字的描述,能锁住的只有"这一类长相"。锁不住"这一个人"。
更麻烦的是,你越是想用文字补,就越容易引入新的漂移源。我见过一种典型操作:发现脸不对,就加一句"整体重绘一遍,提升精致度"。
结果是什么?图确实更漂亮了——皮肤更透,五官更立体,光影更高级。
但那张脸,已经不是原来那个人了。
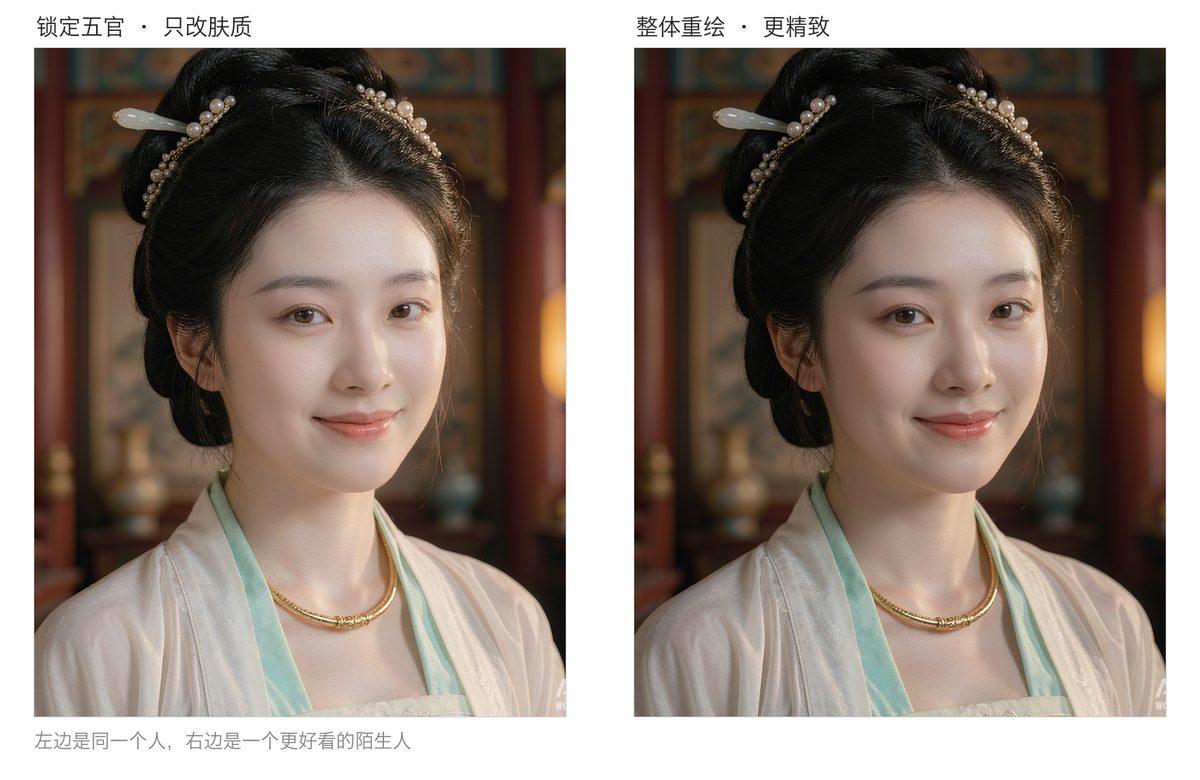
这个取舍,做角色设定、产品形象、品牌人物的人都必须先想清楚一个问题:
你是要一个更好看的陌生人,还是要同一个人。
这两个目标在概率模型里天然打架。你不能既要它"重画一遍",又要它"别变"。
三、真正管用的一招:用图锁,别用字锁
转机来自一个很朴素的念头:既然文字是概率性的,那我不该用文字去描述"不变的东西"。
我换成了一张图。这张就是我的锚点:
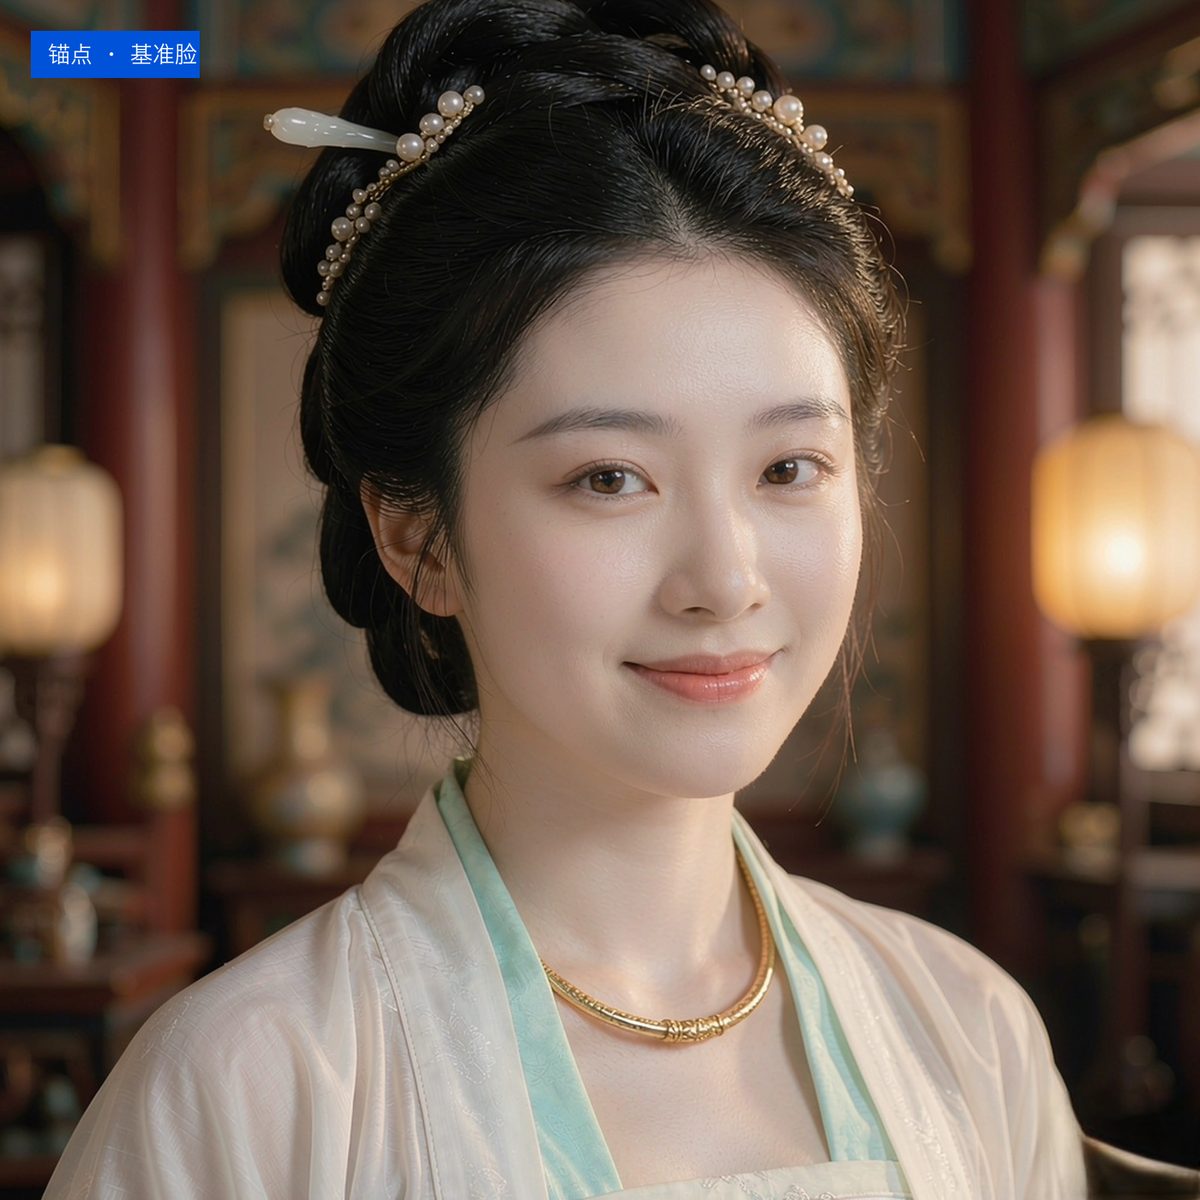
把这张认可的定妆照,直接作为参考图传进去。提示词只留一句锚点:
严格保持参考图中人物的脸型、五官形状、眉眼、鼻梁、唇形、脸型轮廓与气质完全一致,必须看起来是同一个人。
锚点句写完,后面才是场景描述。生成参数上把"对参考图的贴合度"拉到最高。
六个场景,一次过:
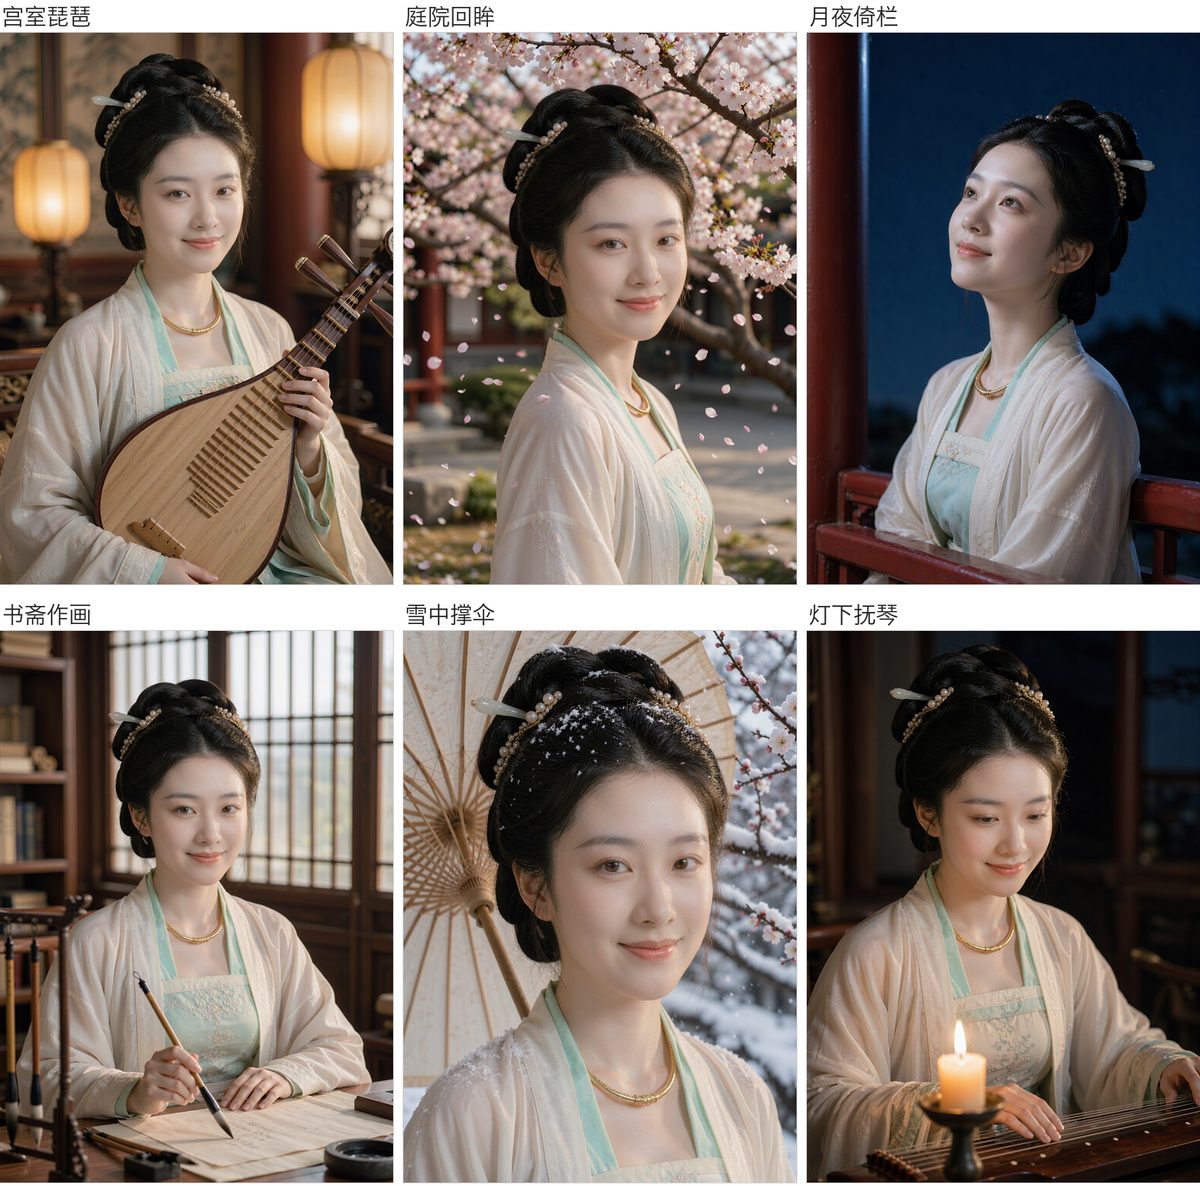
暖黄宫灯下的、春日落花里的、冷调月光下的、窗边天光里的、雪地里的、烛火边的——都是同一个人。
不是"有点像"。是同一套五官、同一副珠花头饰、同一个项圈。
反差最大的那两张摆在一起更明显:一张是暖金色调的深宫室内,一张是冷白调的雪地梅树下:
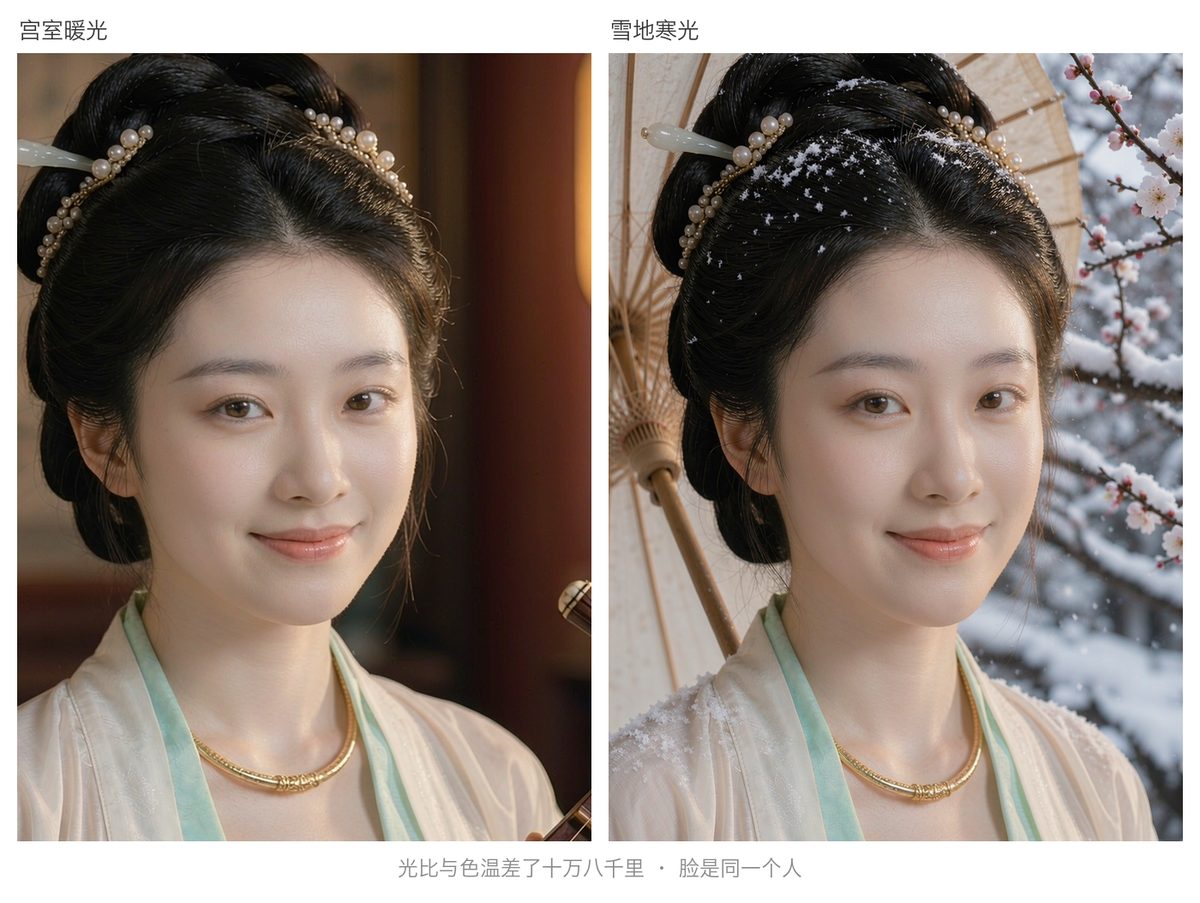
这就是全部的秘密吗?差不多。但有三件事得说清楚,不然你会白试。
第一,参考图管的是"约束",不是"参考"。
这两个词差别很大。你把图丢进去、提示词写一句"参考一下这种感觉",模型只会把它当风格启示——那还是会漂。
必须写成约束:"完全不变""必须一致""不许改"。你不说死,它就自由发挥。
第二,一次只改一个维度。
场景、光线、姿态、服装,这些都在变。你一次全改,出了问题根本不知道是哪一项引起的。
我的做法是:锚点句固定不动,场景描述每次只换一件事。六个场景里,服装我基本没动——这样脸一旦漂了,嫌疑范围就小得多。
第三,锚点句要放在前面。
这不是玄学。描述的顺序会影响模型对各项要求的权重分配。把"不许变"的部分放在最前,等于先立规矩再谈内容。反过来先讲场景再补一句"脸要保持一致",它已经把脸画完了。
四、怎么判断"漂了",而不是靠感觉
这是最容易被忽略的一步。
大多数人判断脸有没有漂,靠的是"我觉得这张不太像"。这个标准不可靠——光照一变,你就认不出来了。
我这次的做法很笨但有效:把两个版本的脸按同一个坐标框裁出来,并排贴。
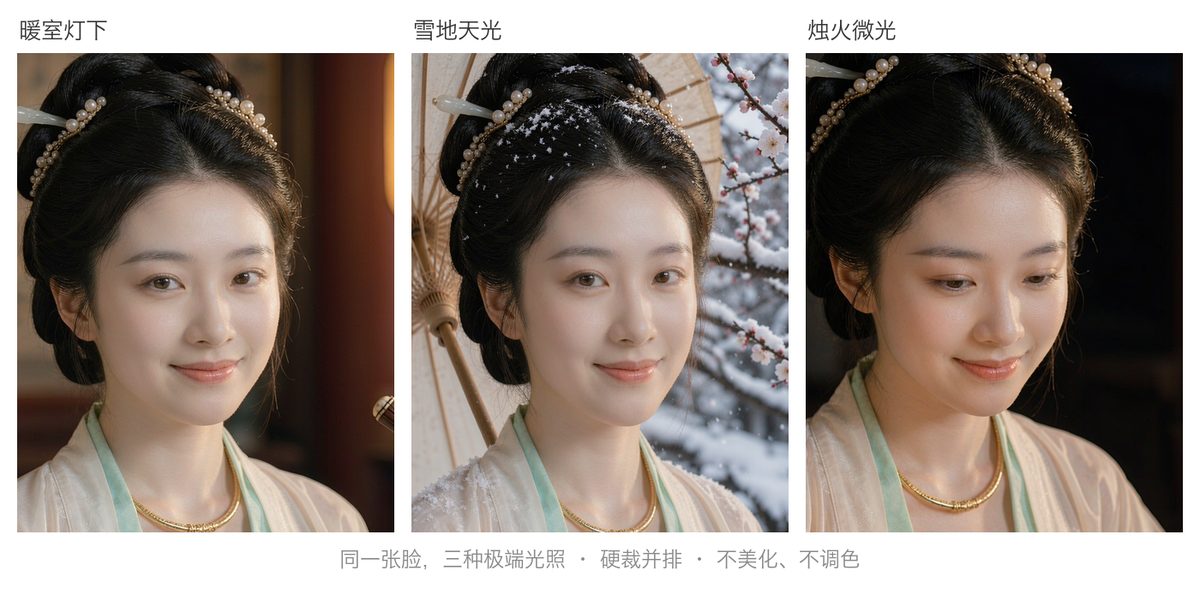
不美化,不调色,不挑角度。就是硬裁、硬贴。
判断标准也简单:你看那张脸的时候,是在看"一个人",还是在看"一个人群里的某一个"。
还有一种更硬核的辅助手段是固定随机种子。它确实有用——但你要知道它管的是什么:种子管的是噪声起点,不管五官。
同一个种子配不同的描述,照样能给你换一张脸。所以种子是"减少波动",不是"锁死身份"。真正锁身份的,还是参考图。
五、可直接抄的流程
把这一轮的经验压成五步:
-
先出一张满意的定妆照,并且认可它。 这张就是你的基准脸,后面所有图都以它为锚。不满意就重出,别将就——锚点错了,后面全错。
-
把定妆照作为参考图传进去,贴合度拉最高。 这一步是本篇的全部重点。
-
提示词分两段:锚点句在前,场景描述在后。 锚点句把所有"不许变"的东西列全——脸型、五官、发型、头饰、服装、配饰。场景描述只写这次真正要换的那件事。
-
一次只改一个维度,改完立刻验脸。 别攒着六张一起看。第一张漂了,后面五张全是白做的。
-
交付前把脸裁出来并排复核。 别靠"我觉得挺像"。
再补一条容易被忽略的:生成完先看右下角。
我这次生成的六张图,右下角全部带着平台的"AI 生成"水印。如果这是要对外发布的物料,直接拿出去就是事故——尤其在你的读者对"AI 味"越来越敏感的今天。
水印不能用色块盖,那样比水印本身更难看。得把它真实擦掉,让底下的皮肤和布料纹理接上。这件事我单独踩过坑,后面会专门写一篇。
最后说两句
回头看,这篇的核心结论和上一篇是同一句话。
上一篇我说:提示词不是描述画面,是指标分配。
这一篇补上后半句:有些指标,根本不该用文字下。
"一个人的长相"就是一个典型。它太具体、太唯一,超出了文字能承载的精度。文字适合说类型、说方向、说氛围;至于"必须是这一个"的事情,交给图。
AI 生图这件事,真正难的不是把提示词写长。
是搞清楚哪些事该说、哪些事说了反而添乱、还有哪些事,压根就不该用说话解决。
那六张图最后一个也没漂。
不是我提示词写得比别人好——是我把该用图的地方,换成了图。
我是老魏,一个专门把 AI 圈的新闻翻译成人话的程序员。这儿不讲参数,不讲架构图,只讲「这事儿到底意味着什么」。
觉得有用就点个关注,咱们下期见。