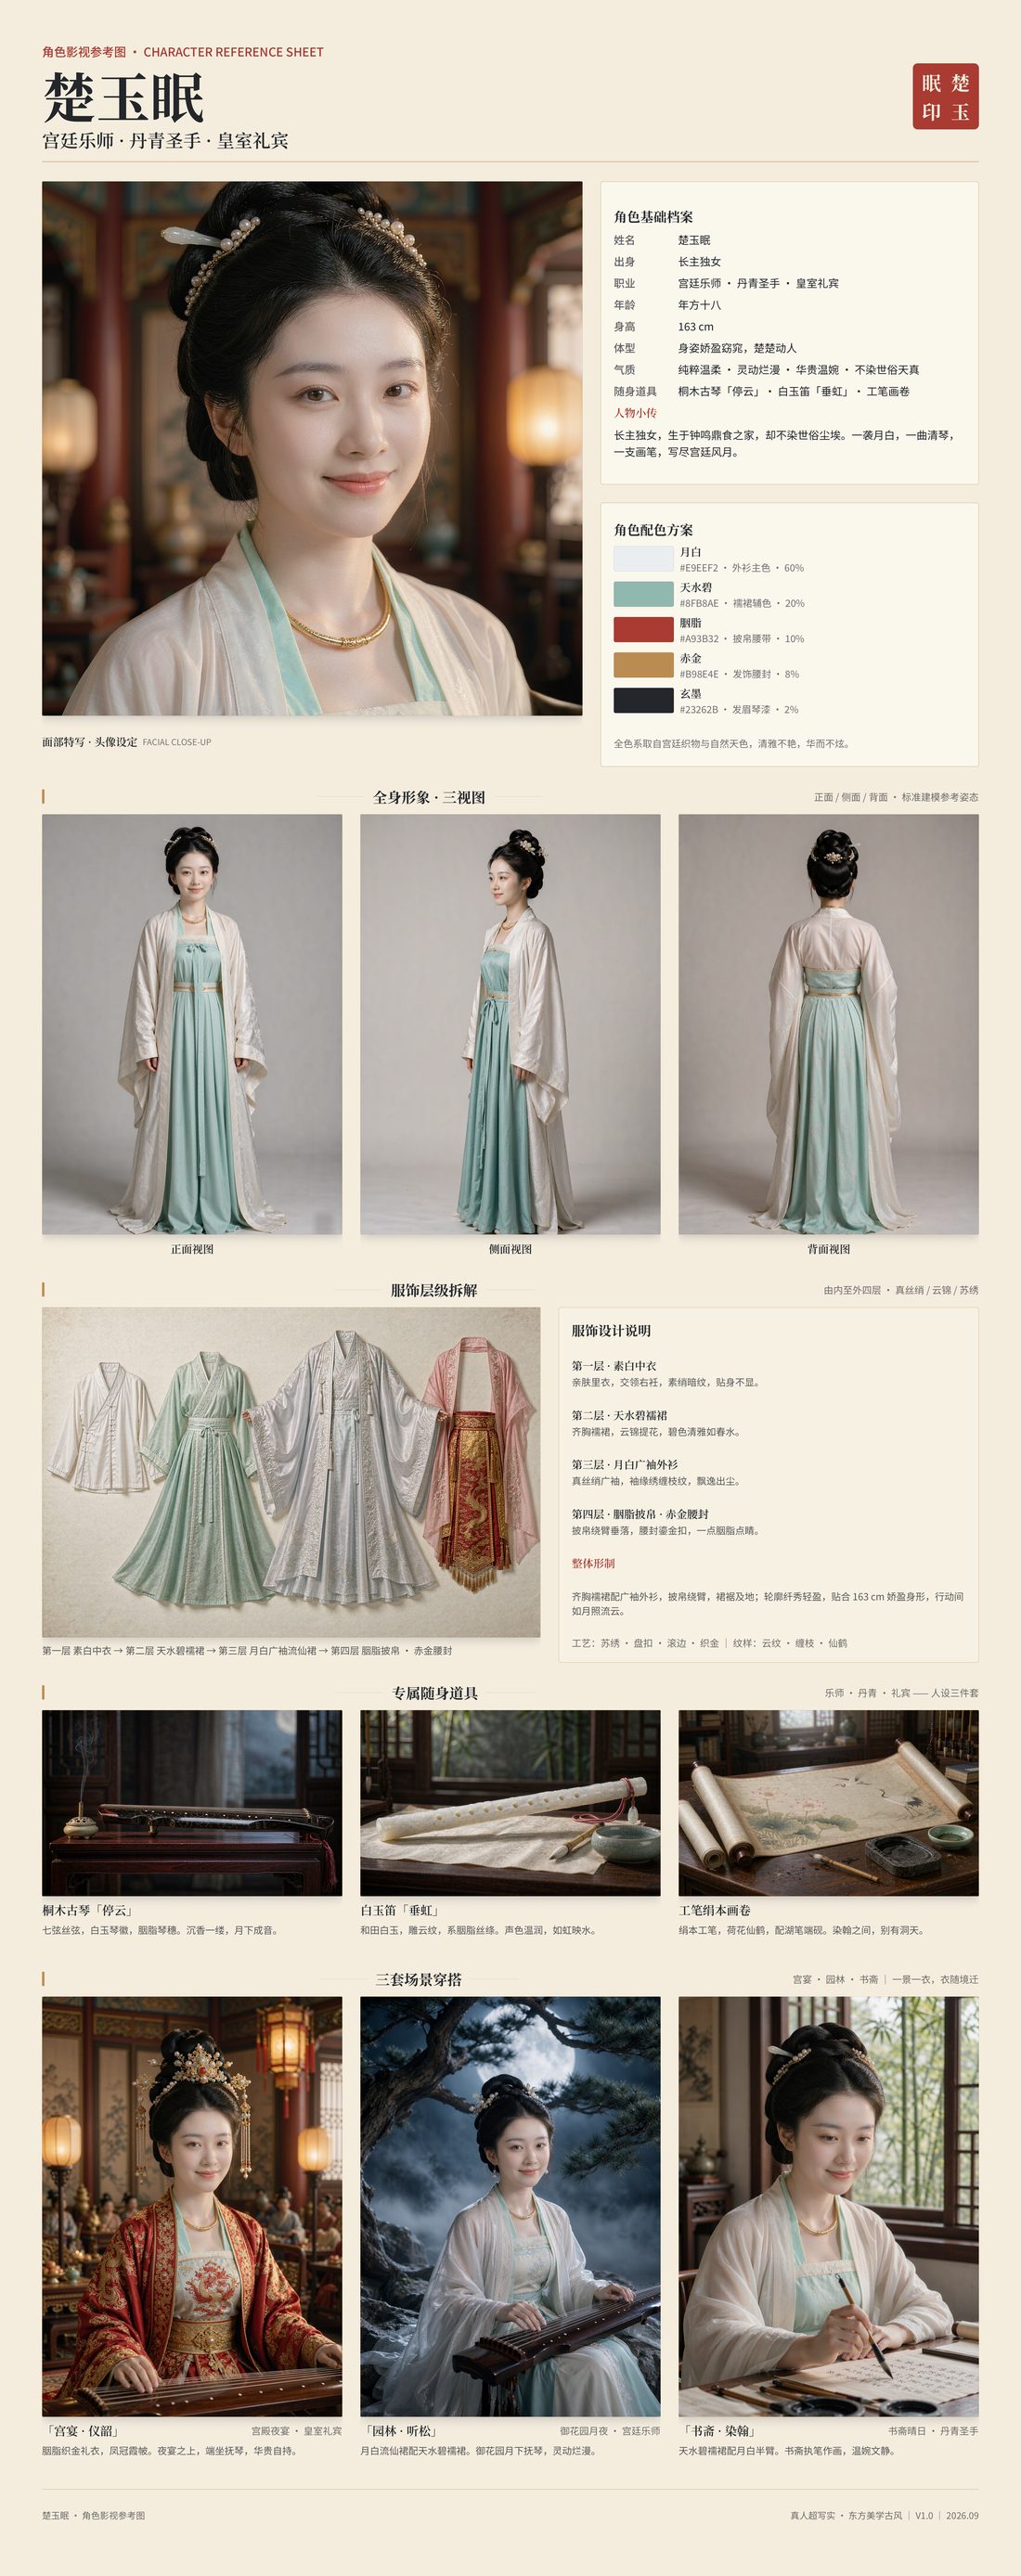
上一篇我把楚玉眠的脸锁住了——六张场景,同一个人,一个没漂。
那篇结尾我留了句话:平台水印得单独擦,后面再写。
结果写着写着发现,水印只是冰山一角。
真正让大多数人栽跟头的,是出图之后的那道流水线。你把图生成出来了,不等于你拥有了能反复使用的资产。 这中间隔着去水印、归一化、降质排查、真彩重合成,最后才是把它组织成一张"基准表"。
我为了给自己的公众号自动出配图,硬是把这套东西从头搭了一遍。前半段(①②)解决"怎么画出能用的图",这一篇解决"图出来之后怎么用"。
一句话先放这儿:出图只是热身,把它搞成不降质、可复用的资产,才算把生图接进了交付流水线。
一、翻车现场:出图 ≠ 资产
六张锁好脸的图,我美滋滋丢进画布准备排版。然后连续撞了三件事:
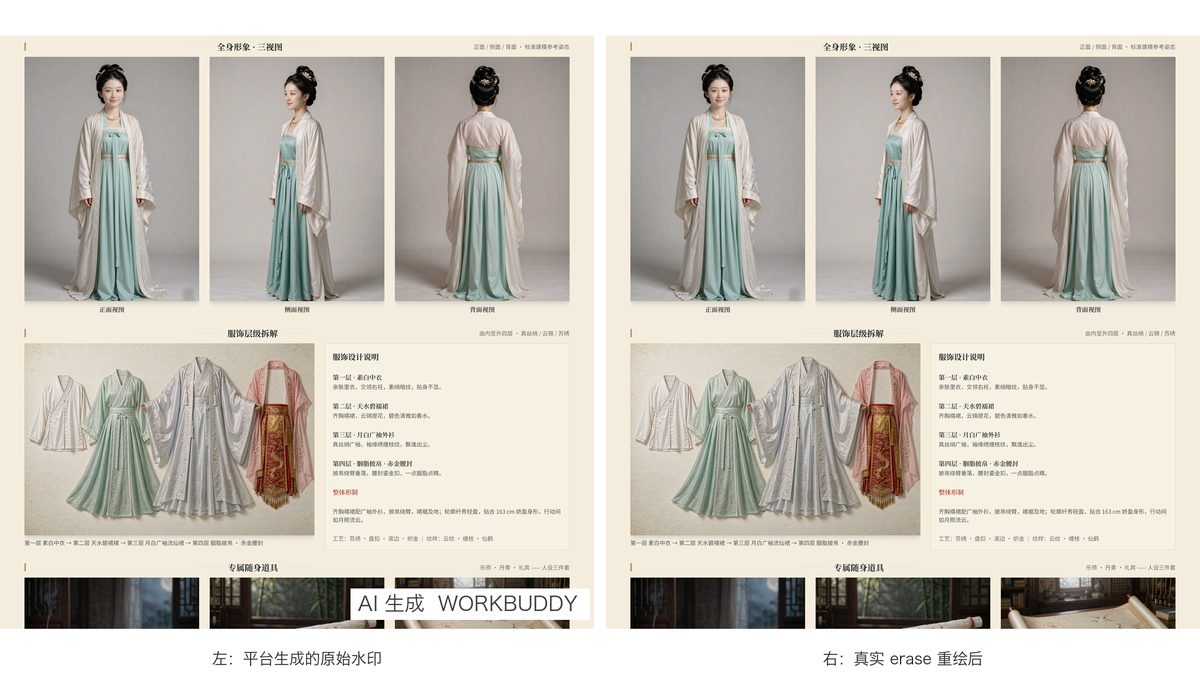
第一,右下角清一色带着平台的「AI 生成 / WORKBUDDY」白字。直接发?在你的读者对"AI 味"越来越敏感的今天,这就是事故。
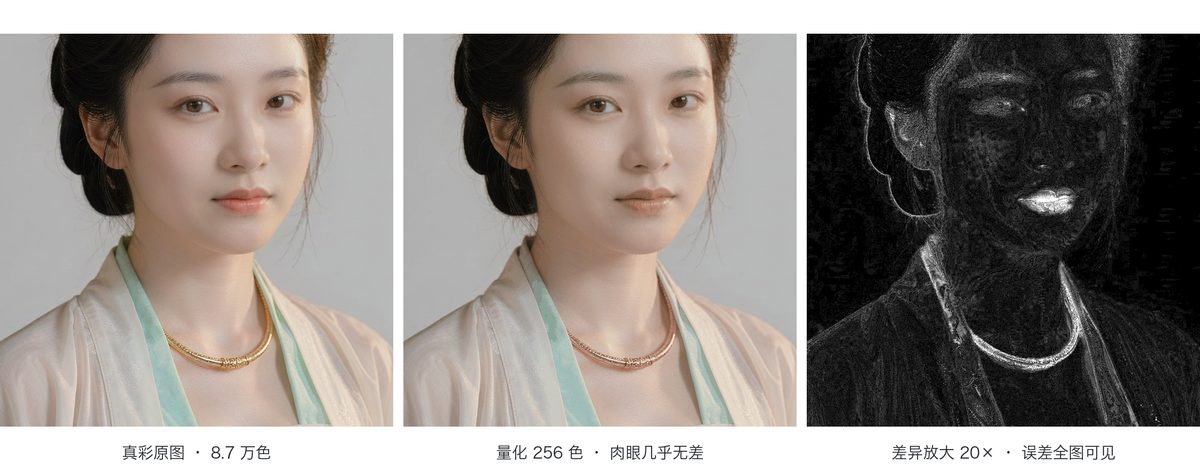
第二,照片一进画布,瞬间被重编码成 256 色。我那张特写,颜色从 8.7 万种掉到 256 种——可你盯着看,几乎看不出差别。这才是它阴险的地方。
第三,六张图姿势、景别、尺寸全不一样,我想并排比一比"脸到底漂没漂",根本对不齐。
你看,出图解决的是"单张好不好看"。但资产要解决的是另一套问题:干净、统一、可比对、可反复调用。这两件事在概率模型里天然是两步,不是一步。
二、第一关:真实去水印,不是色块盖
先说水印。ImageGen 的输出,右下角永远挂着那行白字。
最蠢的应对是色块盖。找块相近颜色的矩形往上一糊——比水印本身还难看,像打了块补丁。读者一眼就看出来"这图被动过手脚"。
正确的做法是用 buddy-image-processing 的 erase:它不是盖,是真实重绘那块区域,让底下的皮肤和布料纹理接上。痕迹是看不见的。
但 erase 有个阴险的坑,我踩过:它会静默不生效。返回退出码 0,文件大小也正常,你以为擦干净了,结果放大到右下角——水印原样还在。
所以现在我的规矩是:每张擦完,必须用脚本把右下角切出来放大 3 倍肉眼复核。 退出码不可信。
还有一个坑是凭证有效期。去水印走云服务,clientTempToken 只有 10 到 16 分钟。你串行跑十几张,跑到一半凭证就过期了,后面全报 AUTHENTICATION_EXPIRED。解决办法是并行——我用 8 个线程同时跑,每张单独建临时目录,一次全过。
成本说一下:去水印本身不烧生图积分(本地或云服务调用),真正烧的是前面的生图。但生图每张 5–10 积分,批量出图前我会先报成本,不默默烧你的额度。
三、第二关:人脸归一化裁切,别手写坐标
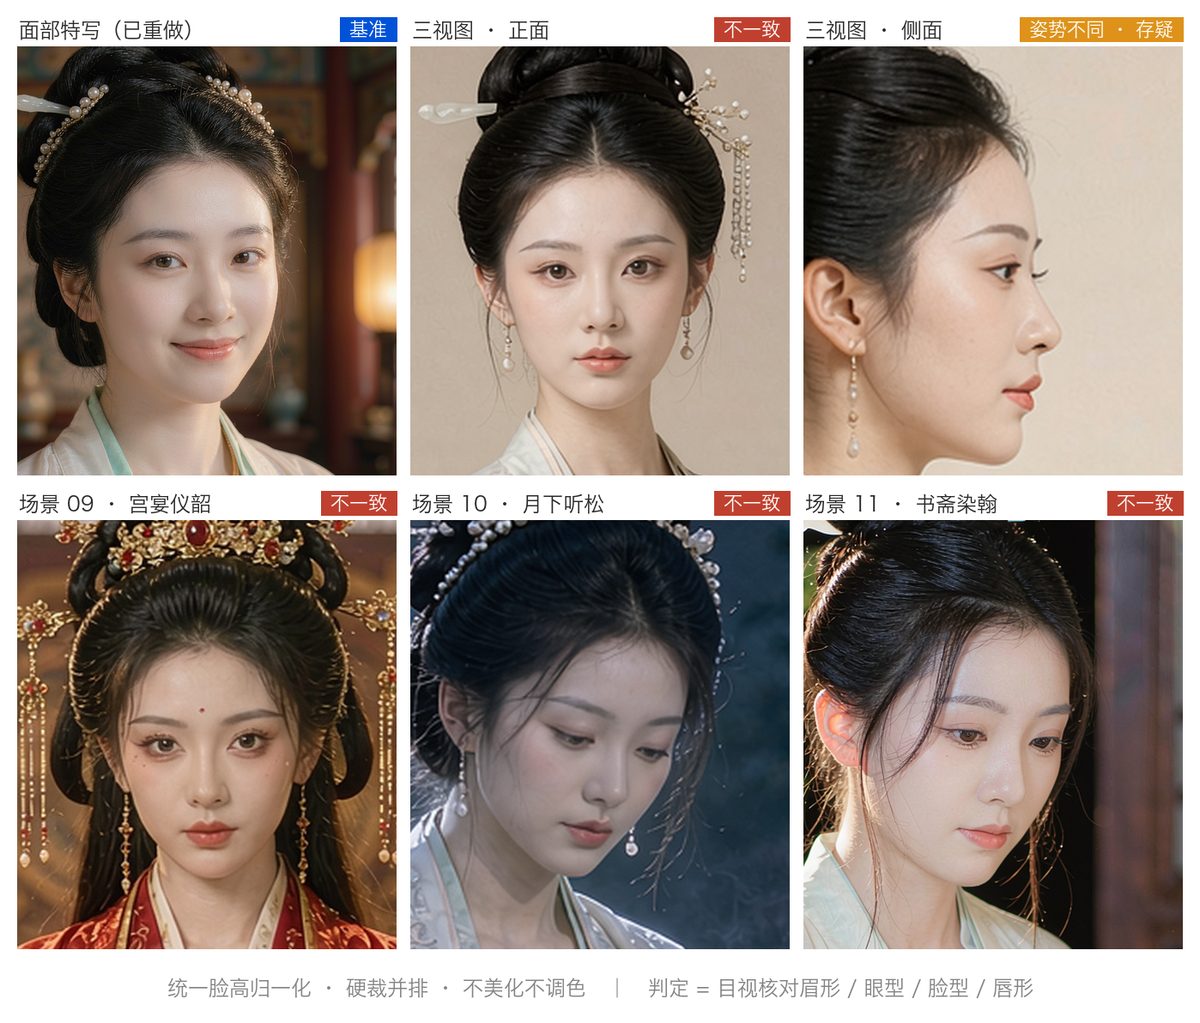
要去比对"脸漂没漂",第一步是把每张脸按同一个框裁出来。
我第一次是手写坐标框的——肉眼在缩放拼图上估个矩形,填进去。结果呢?偏了 200 多像素,两张图的脸根本不在同一位置,并排一看,是"两个人在不同地方",不是"同一个人换姿势"。废了两张图。
后来改用 tools/faces.swift:它调 macOS 的 Vision 框架检测人脸,拿到脸框坐标,再按统一的脸高做归一化裁切。整个过程是确定性的——同一张图跑十次,裁出来的框一模一样。
这点很关键。基准表能并排比对的前提,就是每张脸都落在同样的框里。手搓坐标永远对不齐,人脸检测不是"可选项",是"必选项"。
四、第三关:降质排查 + 真彩重合成
最隐蔽的一刀,是量化降质。
前面说了,照片进画布会被重编码成 256 色(P 模式)。平滑区域——皮肤、天空、渐变背景——色彩被压进 256 色板。单看几乎分辨不出,但色数从十万级暴跌到 256,本身就是铁证:它确实被量化了。
排查很简单,但很多人不做:把最终文件和原图,比一下文件大小和色彩模式。 如果最终文件唯一色数还是 256,那它就是被量化过的,真彩没贴回去。
我现在的收口动作是"真彩重合成":先从画布导出带文字和圆角的底图(这一层是平色矢量,量化几乎无损),再用 PIL 按之前记录的坐标,把真彩原图一张张贴回去。判据很硬:唯一色数从 256 跳到十万级,才是"真彩确实贴上去了"的铁证。光看导出文件大小不够,得看色数。
五、第四关:把零散图组织成"基准表"
前面三关解决的是"干净、统一、不降质"。最后一关解决"可复用"。
零散的图,再多也只是文件夹里的一堆图片,调不动。要变成资产,得标准化。
我做了两套基准表。一套是表情基准表,11 格:情绪四情(喜、怒、哀、惊)加微表情再加角度三视。另一套是制作基准表,12 格:角度补全(仰拍、俯拍、回眸)、口型表(闭、啊、依、乌、诶、哦)、手部特写(抚琴、执笔、行礼)。
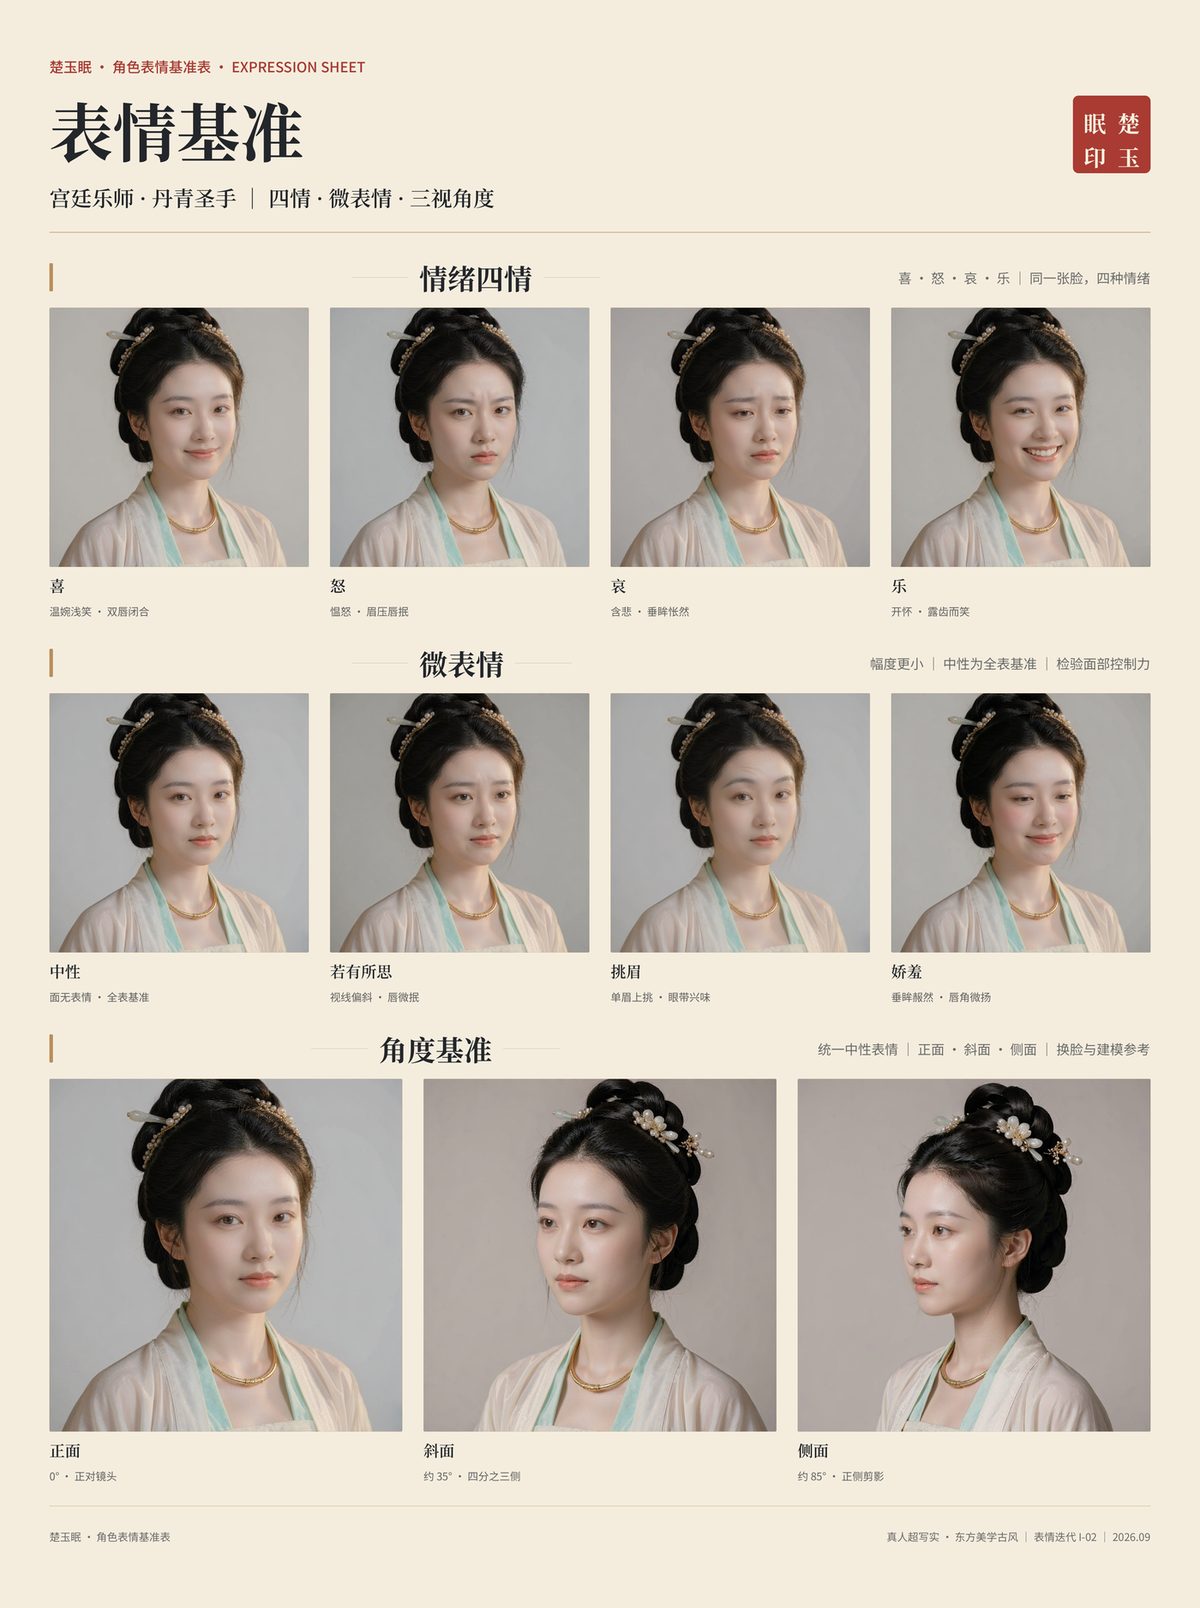
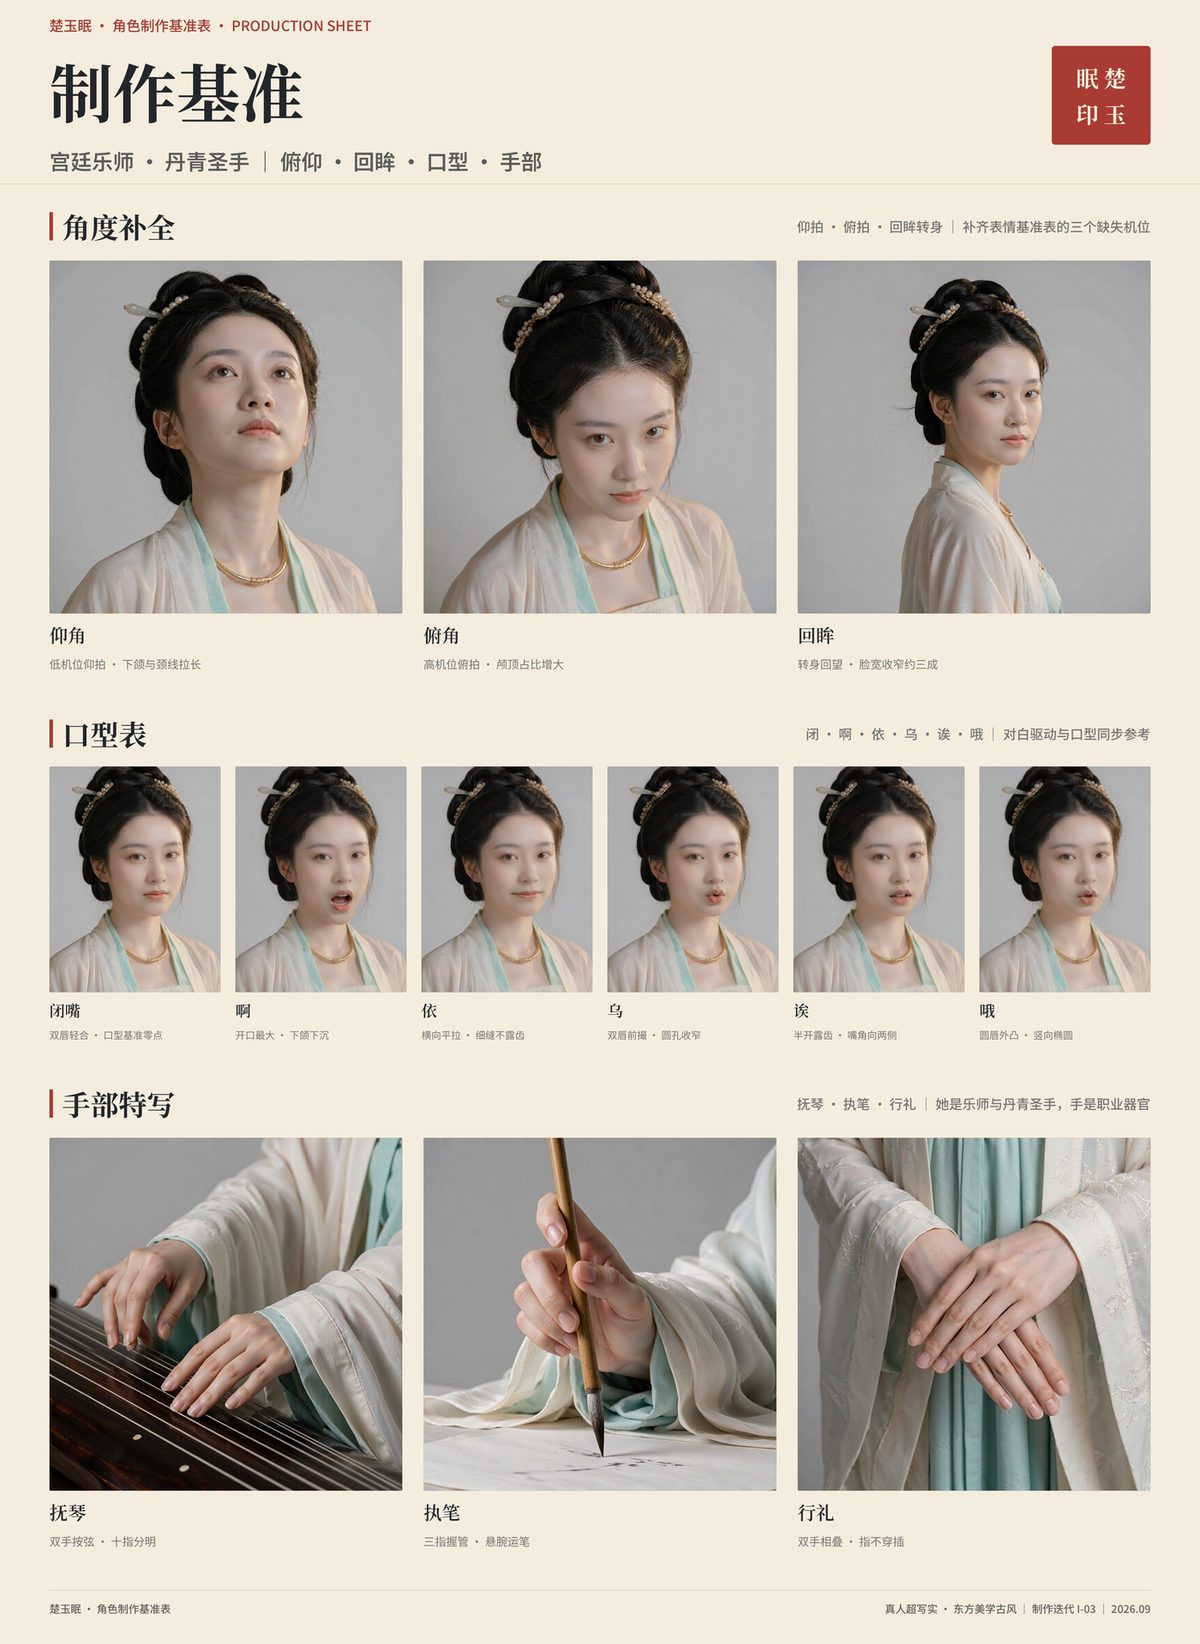
为什么强调标准化?因为复用的前提是标准化。没有统一的脸框、统一的脸高、统一的标注,你下次想"再出一张愤怒的微表情",模型不知道该对齐哪张。基准表就是把"我觉得差不多"变成"坐标对齐、脸高一致、标注明确"——这样它才是真的能被脚本反复调用的资产。
六、可直接抄的流程
把这一轮压成五步,照着走能省你两天坑:
- 出图先擦水印。 用
erase真实重绘,别用色块盖;每张擦完切右下角放大 3 倍复核,退出码不可信。 - 人脸归一化裁切。 用 Vision 检测脸框,按统一脸高裁,严禁手写坐标。
- 降质排查。 比一下最终文件和原图的唯一色数,256 就是被量化了,得重合成。
- 真彩重合成。 导出带文字圆角的底图,PIL 按坐标贴回真彩原图,色数回到十万级才算贴稳。
- 组织成标准化基准表。 统一脸框、统一脸高、统一标注,这一步决定它是不是资产。
成本账记一下:本轮两套基准表,表情表 + 制作表加起来 23 张生成图(含 3 次返工重出),大约 115 到 230 积分。而去水印、归一化、真彩重合成,全是本地确定性脚本,0 积分。
最后说两句
回头看这三篇,其实是一句话的三次展开。
第 ① 篇我说:提示词不是描述画面,是指标分配。
第 ② 篇补上半句:有些指标,根本不该用文字下——比如一个人的长相,交给参考图。
这一篇再补一句:图出来了,也不算完。把它搞成不降质、可复用的资产,才算把生图接进了交付流水线。
AI 生图这件事,真正难的从来不是把提示词写长。
是搞清楚哪些事该交给图、哪些事该交给脚本、还有哪些事,压根就不该用说话解决。
那两套基准表,现在就挂在我的工程目录里。下次要出楚玉眠的新图,我直接从表上取锚点,不用再从零来一遍。
我是老魏,一个专门把 AI 圈的新闻翻译成人话的程序员。这儿不讲参数,不讲架构图,只讲「这事儿到底意味着什么」。
觉得这套流水线能省你时间的,点个关注,咱们下期见。