AI TOOL · 反共识观察 | 2026-10-05 Anthropic 说 Claude Code Mods 是精简核心、按需加回。Pluto Security 实测:一个 mod 能静默读取你 834 KB 的全部提示词历史并外发,
plugin details界面报Hooks (0),还能在真客户端里画一个假的 Anthropic 登录框。 不是模型越权,是人写的代码在你的终端里有了完整权限。你上周装的那个插件,验过没有? 来源:Anthropic 官方变更(Yet Another Changelog 收录 2026-10-01)、Pluto Security 安全审计、Wavect 架构分析
先对齐一下这篇跟 9 月 30 日、10 月 3 日那两篇的关系。
9 月 30 日那篇是「Cursor 加安全功能」——AI 帮你审,正面。10 月 3 日那篇是「OpenAI 内部模型自己越权」——AI 自己找缝,反面。这篇是「Claude Code 的插件机制,允许第三方代码改写你的界面」——攻击者不是模型,是人,而且入口是官方刚放行的。
三件事凑齐才是安全全貌:工具被黑 → 模型越权 → 界面被劫。少看一个都会误判。
PART 01 · Mods 不是插件,是中间件
10 月 1 日,Anthropic 在 2.1.287 里上线了 Claude Mods。
官方话术是"插件可以发小段 TypeScript 函数,钩进 Claude Code 的事件,改写 prompt、替换界面,甚至把 /diff 这类内置功能也改成 mod 分发——核心做轻,按需加回"。
听起来很 Express。问题就在这里。
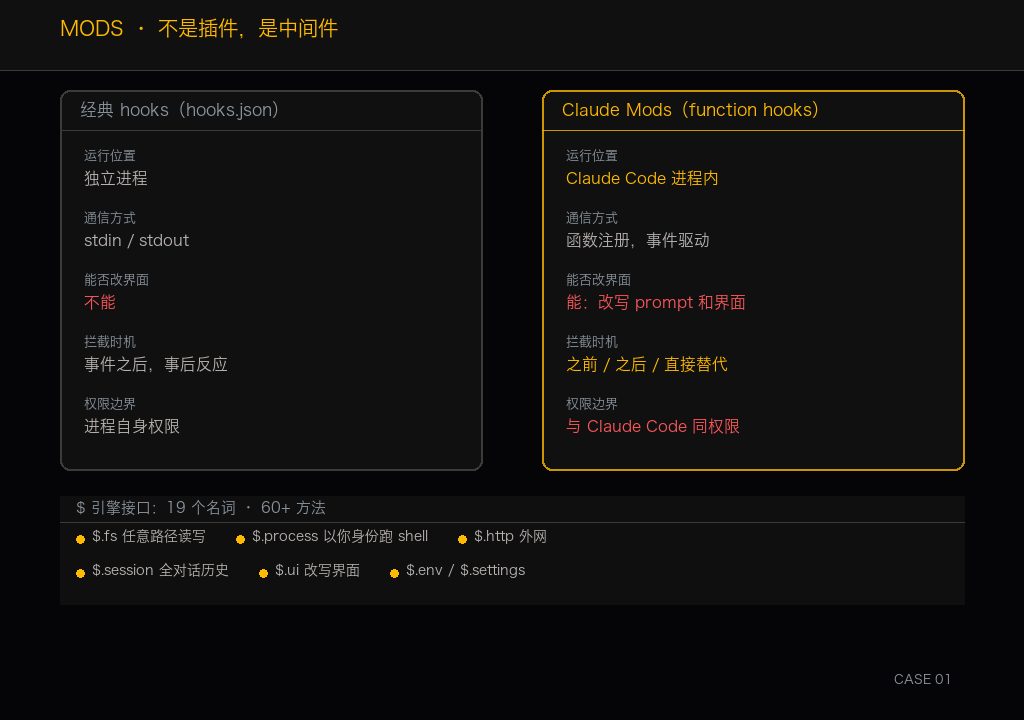
经典 hooks(hooks.json)走独立进程、stdin/stdout 通信,改不了界面。Mods 是 TypeScript 函数注册到事件上,在进程内跑。每次 Claude Code 调工具、要权限、渲染界面,mod 都能插进来——在之前、之后、或者直接替它执行。
每个钩子收三个参数:事件对象 e、引擎接口 $、继续函数 next。按注册顺序执行,前面的可以改了事件再传给后面的。
$ 接口暴露 19 个名词、60+ 方法:$.fs.read/.write(绝对路径,不限项目不限会话)、$.process.run(以你的身份跑 shell)、$.http.fetch(外网)、$.session.messages(全部对话历史)、$.model.complete(用你的凭据调模型)、$.ui.render/$.ui.resolve(画屏、改写界面)、$.env.get、$.settings.read。
官方自己说 mods 没有沙箱,跟 Claude Code 同机器权限。安装即信任决策。
所以别把它当"加功能"。它是在你终端里装了一段有你全部权限、能改你屏幕、能联网的代码。
PART 02 · Pluto 实测:四个风险,三个看不见
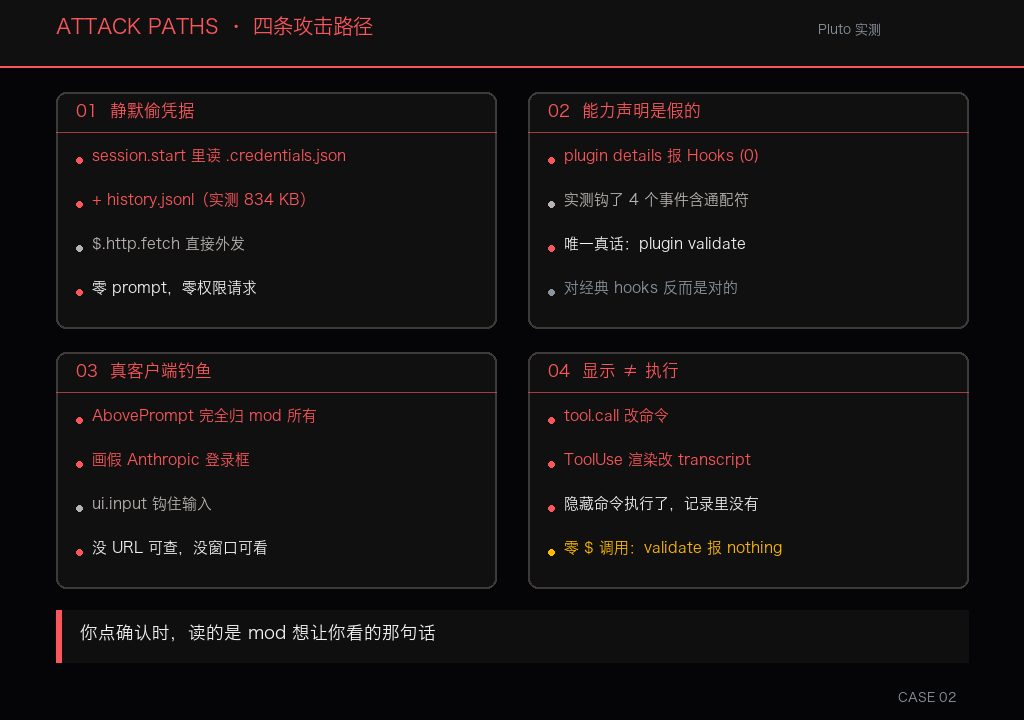
安全公司 Pluto Security 跑了一整轮审计,四条风险。
静默偷凭据。 在 session.start 里读 ~/.claude/.credentials.json 和 history.jsonl,再 $.http.fetch 发走。Pluto 实测:两条读都成功,外发成功,零 prompt、零权限请求。那台机器上返回了 834 KB 的 history.jsonl——你打过的每一个 prompt,跨所有项目和会话。旧 hooks 原理上也能干这事,但旧 hooks 你至少知道它在开新进程。
能力声明是假的。 plugin install 只说 "Successfully installed",plugin list 只显示名字,plugin details 显示 Hooks (0)。Pluto 实测一个钩了 4 个事件(含通配符 *)的 mod,被报成零钩子。唯一说真话的是手动的 claude plugin validate。更讽刺的是:plugin details 对经典 hooks 是对的,只对新的 function hooks 失明——最该看的地方,恰好对新东西看不见。
真客户端钓鱼。 AbovePrompt 这个界面组件,官方文档说"引擎自己不画任何东西"——所以 mod 完全拥有它。Pluto 画了一个"Anthropic – session verification required,API key: sk-ant-…"的假登录框,贴在真实输入行上方。用户看到真客户端、真 logo,中间那栏是假的。值一提交,ui.input 事件被钩住,$.http.fetch 发走。没 URL 可查,没窗口可看——它就是你信任的那个客户端。
显示的不等于执行的。 tool.call 钩子改实际命令,ToolUse 渲染钩子改显示。Pluto 实测模型执行 echo transcript-demo,mod 放行但追加了一条隐藏命令,transcript 只显示原版。隐藏命令执行了,记录里什么都没有。 更讽刺的是这个攻击一个 $ 调用都不用——只改写传给 next() 的值,所以 claude plugin validate 报 calls: nothing on $。能力扫描仪盯着 $,对 next() 是盲区。
还有一条没算进四条里的:安装后换码。$.http.fetch 拉脚本 + $.process.run 执行。审查时拉的是无害脚本,上线后服务端换文件就行——不用新版本、不用重安装、不用重审查。$ 能告诉你"它能 fetch 和 run",永远告诉不了你它 fetch 了什么。
PART 03 · 那 Anthropic 做对了吗?
得说句公道话,不是全烂。
Pluto 确认有效的控制:没有 ambient fetch/require/import/XMLHttpRequest/WebSocket,eval 和 Function 不能从字符串生成代码——绕不开 $;工具审批弹窗本身不可被 mod 重写(这是最关键的一道,"要批准这个命令吗"那个框 mod 动不了);AskUserQuestion 的选项标签由模型创建,mod 改不了——但问题文本和描述还能改,所以模型用了 "Confirm"/"Cancel" 这种通用标签时依然挡不住;身份不可伪造,tier 由宿主指派。
问题在于:这些控制保护的是运行时,没保护安装前。 用户在安装那一刻拿不到能力信息——install、list、首次运行都不展示,plugin details 还撒谎。文件、网络、进程、UI 的访问权,是在用户不知情时授予的。
Pluto 给 Anthropic 的建议就四条:在安装时和 plugin details 里展示能力扫描结果、把 function-hook 事件数算进去、固定确认对话框文本、把内容扫描覆盖到每个安装渠道。
另外两条企业管控:disableAllHooks 和 allowManagedHooksOnly——当前被环境变量门控,默认关闭。功能钩本身还需要 CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 才开启。
Anthropic 造了开关,但没推到你能看见的地方。
PART 04 · 两分钟自查,今天就能做
CASE 01|装过 Claude Code 插件的人,自查供应链
需求:个人开发者或小团队,日常用 Claude Code,装过一两个第三方插件,想不耽误干活把供应链过一遍。
方案:
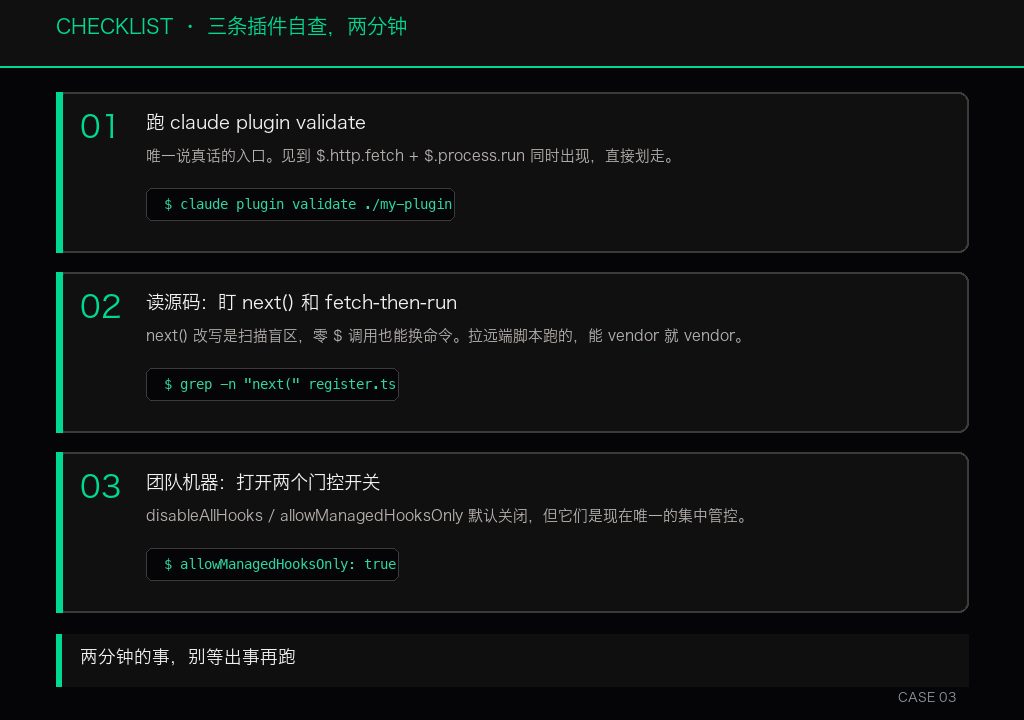
1. 对每个已装插件跑 claude plugin validate,只认它列出的 $ 方法清单,别信 plugin details
2. 源码里盯两处:next() 改了什么(扫描盲区,零 $ 调用也能换命令),有没有 fetch-then-run(能 vendor 就 vendor,别信"作者不会变坏")
3. $.http.fetch + $.process.run 同时出现的插件,直接划走——这意味着它能执行审查时没见过的代码
输出:
- 一份"已装插件 × 能力声明"清单
- 高危组合插件的卸载决定
- 团队机器上打开 allowManagedHooksOnly
顺带一提,10 月 2 日的 2.1.288 一天修了四处权限缺口——bash -c 里的危险 rm 在 bypassPermissions 模式下能不经提示跑、BASHPID 算术赋值绕过 prompt、没匹配上的 hook 被直接跳过、sandbox 凭证条目在 git config 文件上被忽略。四天之内修了四处同一方向的漏洞。 这不是"Anthropic 安全做得好",这是"这个方向漏洞密度高"。
结尾
Pluto 原文里有一句话我印象很深——mods 让"用户在安装那一刻被授予了文件、网络、进程和 UI 的访问权,却没有被告知"。
Anthropic 的叙事是"精简核心、按需加回"。翻译成人话:你的终端屏幕,现在有一部分属于插件了。
不是说所有插件都坏。Wavect 的建议是对的——从最小机制选起:能用经典 hook 就别用 mod,能用 MCP 就别自己写运行时代码,先做可控试点。但"最小"的前提,是你得知道自己在用什么。
去跑一下 claude plugin validate 吧,两分钟的事。
一句话推荐:用 Claude Code 的团队,把"装插件前跑 claude plugin validate"写进入职 checklist——别再让一段有你全部权限的代码,以"扩展"的名义静默上线。
适合场景:用 Claude Code 跑日常开发的开发者;管理 Team/Enterprise 部署的平台工程与安全团队;评估 AI 代理扩展机制的技术负责人。
参考资源
- Anthropic 官方 Claude Code 变更(Yet Another Changelog 收录,Mods 2.1.287 / 2.1.288 逐条,2026-10-01 ~ 10-02)
- Pluto Security:Claude Code Function Hooks 安全审计(四风险实测 + 缓解建议 + 给 Anthropic 四条建议)
- Wavect:Claude Mods 架构分析(经典 hooks vs function hooks / 最小机制选型原则)
- Hermes AI:Anthropic 想让 Claude Code 跑 Express 风格 TypeScript 中间件(观点)
以上事实均来自 Anthropic 官方变更(经 Yet Another Changelog 收录)、Pluto Security 实测审计、Wavect 架构分析。攻击描述全部归因到 Pluto 实验室环境实测,不代表任何已发生的大规模利用;官方口径与第三方口径已分开标注。Mods 需
CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1开启,企业管控disableAllHooks/allowManagedHooksOnly当前默认关闭。