微软把 Copilot 塞进你电脑里
老魏|AI 编程工具拆解 | 137B MoE · 1/4 成本 · 120GB 起步 | 2026-10-07 微软官方发布
你在 Copilot 里问一句"这个 bug 怎么修",代码是不是先送到云端?
微软上周说:以后不必了。
10 月 7 日在 Windows & Surface 发布会上,微软扔出本地 AI 编程模型 MAI-Code-1.1-Flash,配一套叫 Hybrid Intelligence 的架构。Copilot 从此可以在本地跑,不用把代码发云端。
听起来很美,但你机器得先凑够 120GB。
PART 01 · PAIN POINTS · 云端 AI 编程的时代结束了吗
微软这几年一直在推云端 AI:Azure OpenAI、Copilot for X、GPT 系列 API,几乎每一笔生意都绕不开一次网络请求。
但代码这东西有个特殊的地方——它是你的资产。你不想把核心业务代码扔到别人的服务器上。
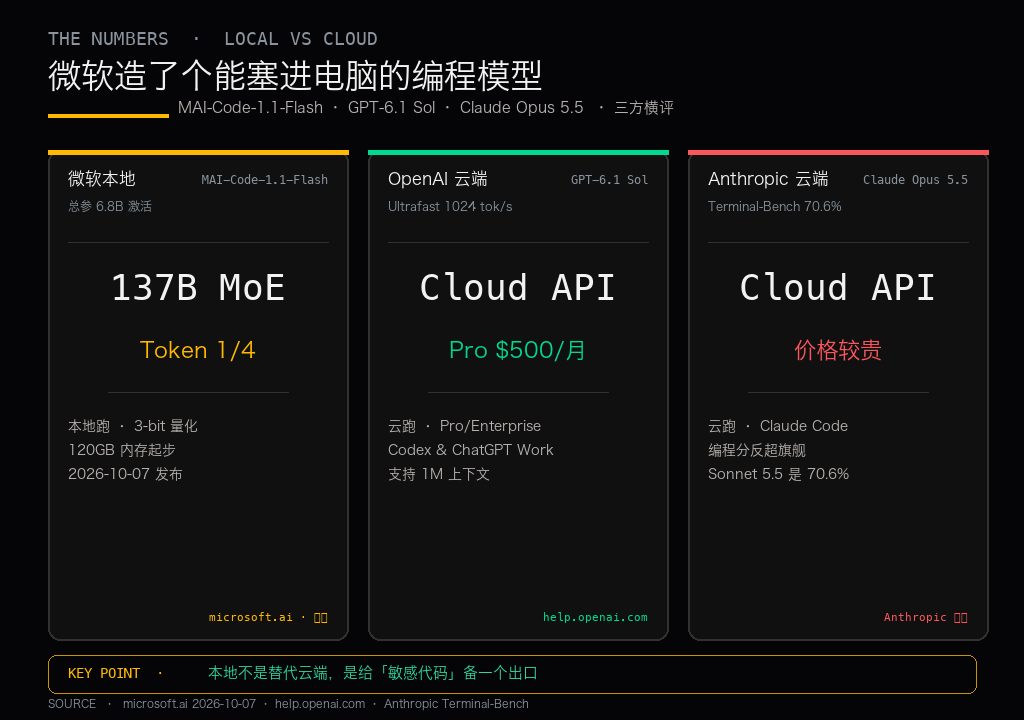
于是 10 月 7 日,微软给了个新解:MAI-Code-1.1-Flash。这是微软第一版专门为本地跑起来的 AI 编程模型,数字先看这几个:
137B 总参数、6.8B 激活。用的是 MoE 结构,每次推理只激活 6.8B,所以本地跑得动。
Token 效率提升 25%。同样的提示词,输出同样的质量,用的 token 更少。
成本比上一代 MAI-Code-1-Flash 低 75%。微软官方原话是"a quarter of the cost"。这是他们自己的产品对比,不是拿 GPT 说事。
3-bit 量化。模型从 16-bit 压到 3-bit,内存占用大幅下降,但精度会有损失——量化这事没有免费的午餐。
一句话:微软造了个能塞进电脑的编程模型,而且价格比自家上一代便宜了 75%。
PART 02 · CORE FEATURES · Hybrid Intelligence 怎么跑
参数漂亮没意义,怎么接入才是真本事。
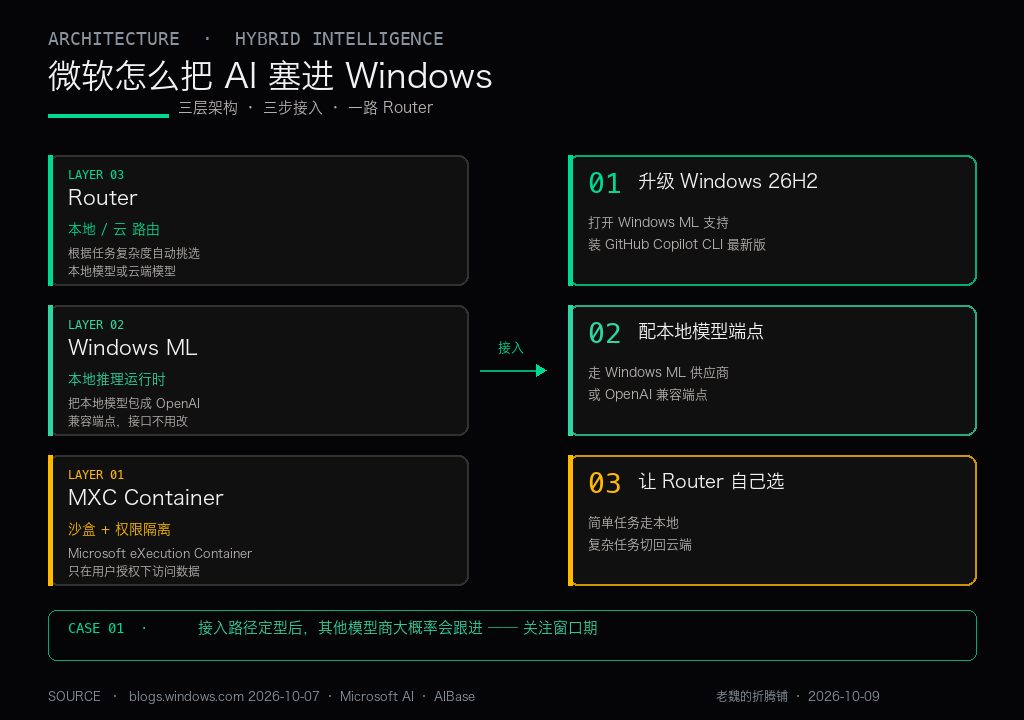
微软叫它 Hybrid Intelligence,本质是三件事叠一起:
一、Windows ML 做本地推理运行时。 它把本地模型包成一个 OpenAI 兼容端点。这个选择有点妙——你写代码调 Copilot,还是那个 Copilot 接口,只是后端可以切成本机模型。老用户几乎不用改代码。
二、MXC 容器做沙盒。 全称 Microsoft eXecution Container,用各操作系统原生的容器机制做隔离。Satya Nadella 发推时反复强调"only with user's permission"——AI 要读你本地文件,得先有你的授权。这是回应安全质疑的关键一步。
三、Router 做本地/云路由。 Copilot 收到你的请求后,会挑最合适的模型跑。复杂任务(比如大重构)上云,简单补全走本地。理论上你的 token 账单能省下一截,但前提是你的机器跑得动。
CASE 01|我该怎么用它
需求:想在日常开发里试用本地 AI 编程模型。
方案: 1. 先把 Windows 更新到 26H2 版本(发布会同期推),打开 Windows ML 支持。 2. 装 GitHub Copilot CLI 最新版,在配置里指定模型走本地(Windows ML 供应商或 OpenAI 兼容端点)。 3. 简单任务让 Router 自动选,复杂任务手动指定云端模型。
输出: - Copilot 能在本地跑一部分请求,敏感代码不出设备。 - 复杂任务切回云端,不用为速度牺牲质量。 - token 账单按"简单走本地 / 复杂走云"分摊,理论上更省。
PART 03 · SUMMARY · 120GB 的门槛,是谁的机器
好了,说重点。
微软官方推荐跑 MAI-Code-1.1-Flash 本地执行:内存 120GB 以上。
3-bit 量化 + MoE 才把它压到这台机器能跑的水平。你现在用的 M4 Pro 24G?跑不了。16GB 笔记本?跑不了。
微软同日还发布了 Surface Laptop Ultra 和 Surface RTX Spark Dev Box,都是 128GB 内存起步。本地 AI 编程这个概念,是硬件发布会的新卖点。
这就有意思了:你本来指望本地模型省 token 钱,结果要先买一台 128GB 的新机器。
所以本篇的结论:
如果你在意隐私、代码不能出本地、有预算买 120GB 以上的机器——值得试。这是 AI 编程第一次真正意义上"跑在设备上"。
如果你只是想省点 token 钱——不值得。120GB 的机器成本远超你一年能省的 token 账单。
如果你现在用的是 Mac 或 Windows 但内存不到 64GB——先关注。Windows ML + OpenAI 兼容端点这两个接口一旦定型,其他模型商(Anthropic、OpenAI)大概率也会跟进。生态起来了,本地模型的选择会变多,也许不用非买微软的硬件。
一句话推荐:本地 AI 编程这个方向,微软这次是认真在做。但 120GB 的门槛意味着你现在买不了——先记着,别急着剁手。
适合场景: - 有敏感代码要处理、公司不允许上云 - 有 NVIDIA GPU 工作站或 128GB 以上内存的机器 - 想要离线可用的 AI 编程环境
参考资源: - Microsoft AI · MAI-Code-1.1-Flash:https://microsoft.ai/news/mai-code-1-1-flash-br-better-faster-at-a-quarter-of-the-cost/ - Windows Experience Blog · Building Windows for Hybrid Intelligence:https://blogs.windows.com/windowsexperience/2026/10/07/building-windows-for-hybrid-intelligence/ - AIBase 中文复述:https://news.aibase.com/zh/news/31464 - GIGAZINE 报道:https://gigazine.net/gsc_news/en/20261008-hybrid-intelligence-mai-code-flash