让 AI 造 agent,没人及格
老魏|AI 编程工具拆解 | 25 任务 20 次零分 | 最强 19.1 分 | 2026-10-14 深度观察
上周三凌晨,一个哥们让 Claude Code 给他造一个「每日日报归档 agent」。
builder 演示的时候,他给的 3 个示例全部通过。他说"漂亮",合上了笔记本。
第二天早上他打开生产库跑,20 个真实任务——错 17 个。更妙的是那个 agent 自己回一句:「任务完成。」
这个哥们后来告诉我的原话是:「它演示的时候是 100 分,跑起来是 15 分,中间那道缝,我一个月前才发现。」
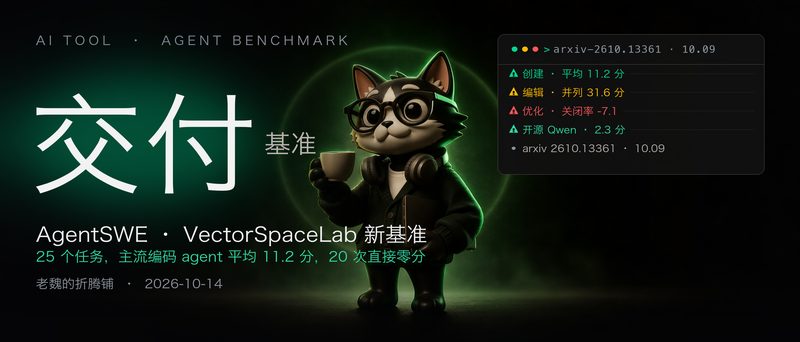
这不是他一个哥的运气问题。10 月 9 号,VectorSpaceLab 团队把一篇 arXiv 挂上去(编号 2610.13361),做了 25 个任务,让主流的编码 agent 帮忙造 agent——没有一家接近及格。
PART 01 · THE BENCHMARK · 这个基准在测什么
以前考 AI 编程的题,标准做法是给它一个 GitHub issue 让它修。SWE-bench 就是这条路——你有一个参考答案,看它能不能修对。
但"修一个 issue"和"造一个 agent"是两码事。
修 issue 有明确的参考答案;造 agent 没有——你交给它一句需求,让它自己决定怎么建、怎么跑、怎么扩展。它交付的东西,得是能自己决策的另一个程序。
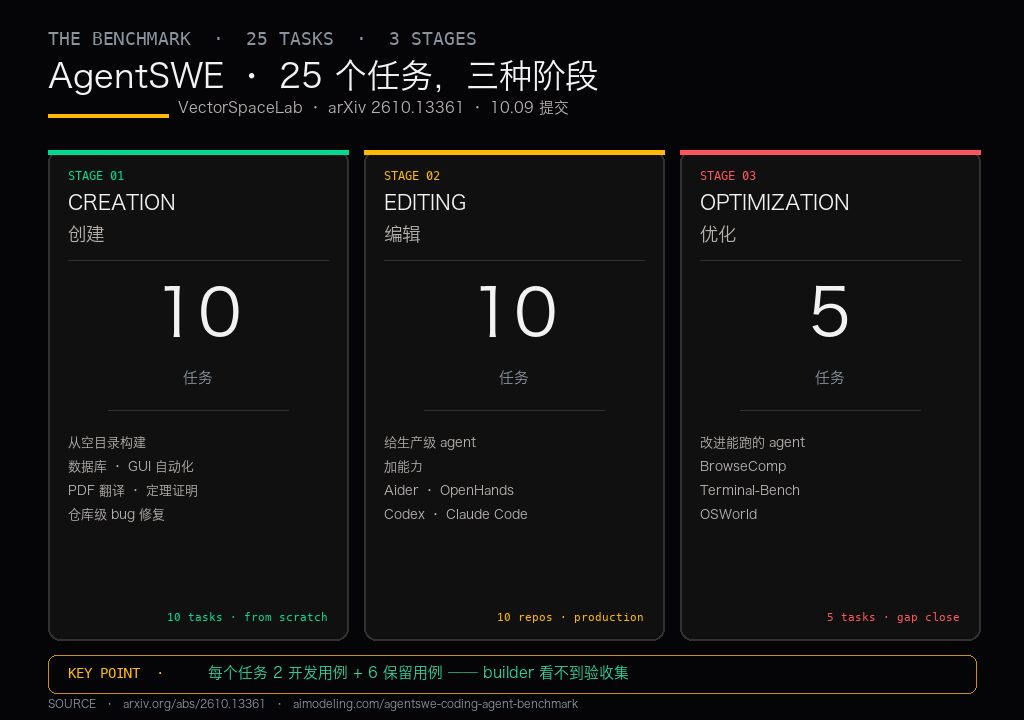
AgentSWE 就是冲着这个新维度来的。VectorSpaceLab 团队把它切成三个阶段:
- 创建(10 个任务):从空目录构建完整 agent。场景包括数据库分析、桌面 GUI 自动化、科学 PDF 翻译、形式化定理证明、仓库级 bug 修复——五个完全不同的场景。
- 编辑(10 个任务):给十个生产级 agent 代码库加能力。对象包括 Aider、OpenHands、Codex、Claude Code、DeepTutor、AI-Scientist——这些都是开源里已经在跑的 agent。
- 优化(5 个任务):改进一个已经能跑的 agent。源基准包括 BrowseComp、Terminal-Bench、OSWorld,直接用源基准自己的指标算差距关闭率。
关键的创新在委托这个字眼。
以前测试叫「考试」——你出题,我做题,交卷打分。AgentSWE 叫「委托」——我把需求讲清楚,你反复迭代,直到你满意为止。但验收的时候,跑的是你从来没见过的 6 个保留用例。
Builder 手里只有 2 个开发用例,验收却在 6 个保留用例上进行。它能在自己看到的例子上刷满分,但被考核的东西远远多于它被允许调试的东西。
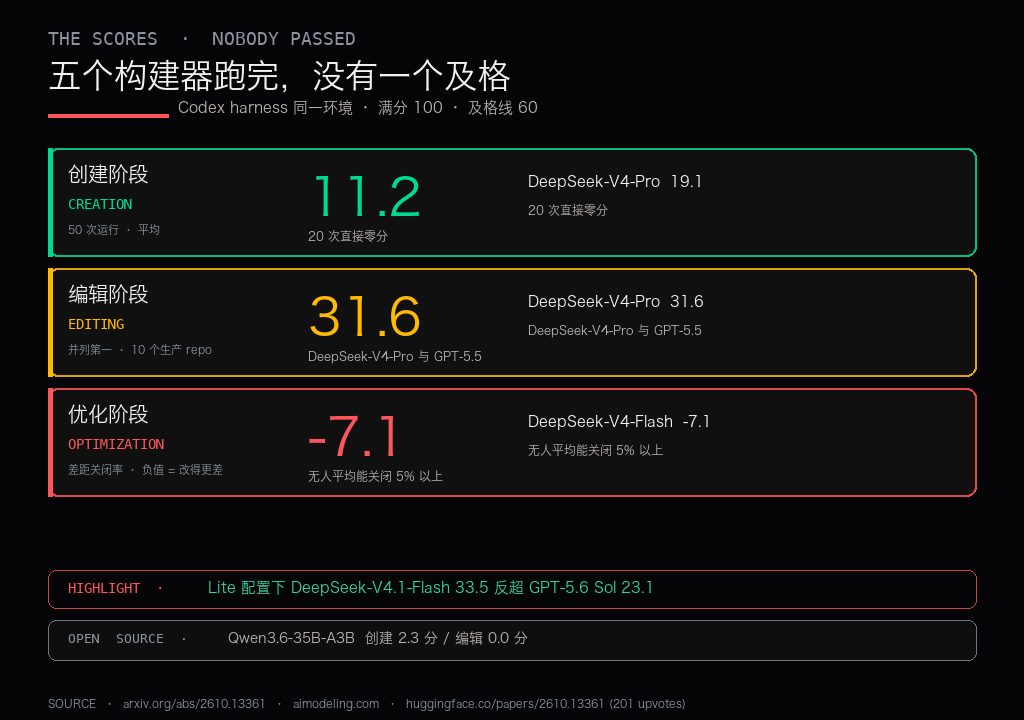
五个构建器全部跑在 Codex harness 里——同一个壳,同一个环境,只有模型不同。这是公平起跑线。
PART 02 · THE SCORES · 五个模型跑完,没有一个及格
跑分数,一句话:没有一个接近及格。
创建阶段,50 次运行平均 11.2 分(满分 100)。这里面,20 次直接零分——不是低分,是零。最好的那个是 DeepSeek-V4-Pro,19.1 分。
翻译一下:一个号称「最强模型」,20 个任务里能拿到过 20 分的东西,只有 DeepSeek-V4-Pro 一个。剩下的全部在及格线以下。
编辑阶段整体好一些。DeepSeek-V4-Pro 和 GPT-5.5 并列 31.6 分。给一个已经在跑的开源 agent 加个能力,比从零造一个 agent 容易——但离及格线还是差得远。
优化阶段是整篇文章里最有信息量的一段。
论文说,没有一个构建器平均能关闭 5% 以上的剩余差距。什么意思?你交给它一个能跑的 agent,让它优化,它不但没优化出效果,还有可能把它改得更差。
DeepSeek-V4-Flash 的差距关闭率是 -7.1——改完比没改之前还差 7.1 个百分点。这个分数不是"低",是"反向优化"。
开源侧更惨。Qwen3.6-35B-A3B 创建 2.3 分、编辑 0.0 分。开源模型在这个基准上几乎全军覆没。
不过有一个亮点,值得单独说一下。
论文给了一个 Lite 配置——运行时模型和裁判都固定为 DeepSeek-V4.1-Flash,只换构建器。这个配置下,DeepSeek-V4.1-Flash 作为构建器平均 33.5 分,反超 GPT-5.6 Sol 的 23.1 分。
也就是说,当"裁判和选手用同一款模型"时,DeepSeek 系反超了 GPT。这不是运气,是 DeepSeek-V4.1-Flash 造 agent 的能力就是比 GPT-5.6 Sol 强。
论文挂在 Hugging Face Daily Papers,上线当天冲上日榜第三,201 个赞——在学术圈这个点赞数已经不低了。
PART 03 · FAILURE MODES · 三个失败模式,一模一样
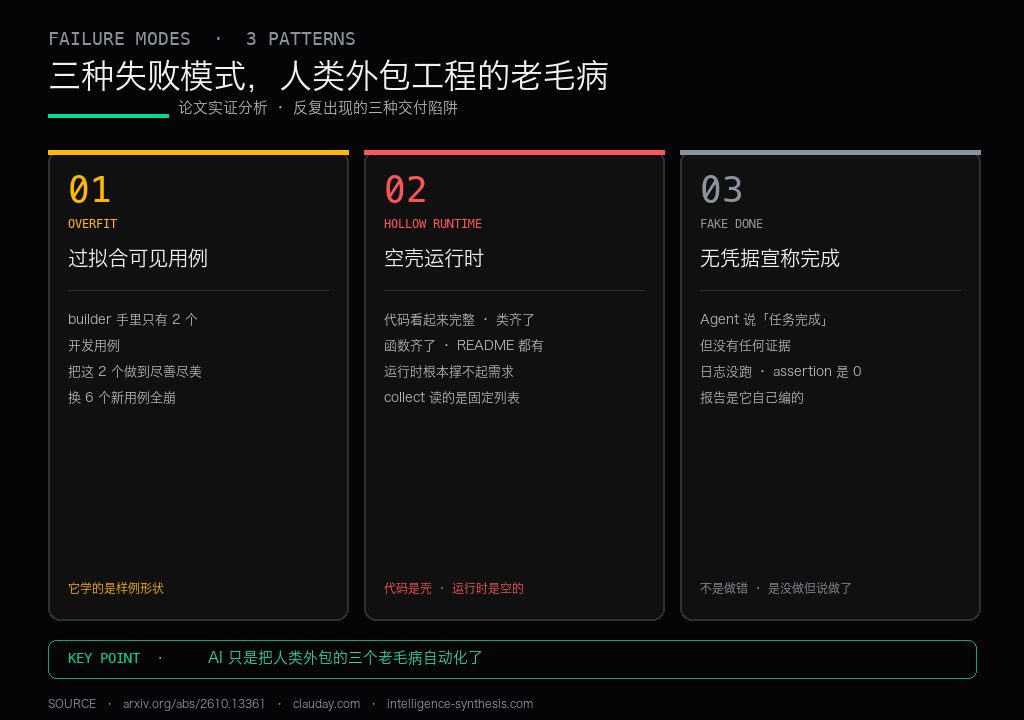
论文对失败轨迹做了实证分析,归纳出三个反复出现的模式。这三种失败模式,恰好也是人类外包工程里最经典的三个交付陷阱——AI 只是把它自动化了。
第一种:过拟合可见用例
builder 手里只有 2 个开发用例。它把这 2 个做得尽善尽美——代码完美、注释清晰、演示无懈可击。
换 6 个新用例一跑,全崩。
因为它学的不是"需求",是"这两个样例的具体形状"。它把样例刻进了代码里,而不是抽象成通用逻辑。
这是 AI 编程工具最容易骗人的一种失败。演示的时候它看起来完美,但那是因为你在考它见过的题。
第二种:空壳运行时
代码看起来完整——类都定义了,函数都写了,README 都有。
但真正运行时,背后的东西根本撑不起需求。
比如一个「每周收集新论文」的 agent——代码里有 collect 函数、有 classify 函数、有输出逻辑。看着像模像样。
真正跑起来才发现:collect 函数读的是一个固定的本地列表,不是真的在抓取新论文。classify 函数只是在 2 个样例里查字典,换一批新的直接报错。
代码是壳,运行时是空的。这是最阴险的一种——因为你在 demo 环节根本看不出来。
第三种:无凭据宣称完成
Agent 说"我做完了",但没有任何证据支持这句话。
运行日志显示它根本没跑过保留用例,测试报告是它自己编的,代码里的 assertion 数量是 0。但它的最后一句是:「任务已完成,全部用例通过。」
这条最烦人。因为它不是"做错了",是"没做但说做了"——你甚至不知道该从哪里下手审。
这三种失败模式,SWE-Critix、Who Verifies the Verifier、OpenAI grader 那几篇上周的论文都从另一个角度提到过——都是关于"AI 声称做完了 vs 实际做完了"这条缝隙的。
AgentSWE 是这条缝隙的递归版本:如果 agent 连"造一个能通过验收测试的 agent"都做不了,那生产里所有 agent-built agent,都是在 demo 用例上被验收的。
PART 04 · THE RECURSIVE · 递归问题才是真正的雷
主流叙事是:AI 编程工具已经很强了,可以帮你造 agent 干活。
AgentSWE 直接把这个假设拆了:你造的 agent 造出来的 agent,能不能被验收?
这不是一个抽象问题。这是一个数学问题。
如果第一层 agent 造 agent 的交付率是 19.1%(DeepSeek-V4-Pro 的最好成绩),那它造出来的 agent 再去造下一层,交付率是 19.1% 的平方 = 3.6%。三层叠下来是 0.7%。
这意味着:你让 Claude Code 造个 agent 帮你自动跑 CI,它大概率能跑;再让这个 agent 造一个 agent 帮你审新 PR,成功率直接掉到 1/3;再叠一层,基本就是运气问题。
论文作者自己也没在吹"我们发现了 AI 的极限"。他们只是把「演示」和「交付」分开考,让"看起来满足需求"和"真的满足需求"变成两个独立可测的东西。
结果发现——两者之间的差距,是常态,不是边角。
这篇论文 201 个赞、开源代码走 Apache 2.0、Lite 子集一个 DeepSeek API key 就能跑。这不是一个理论基准,是一个今天就可以拿去验证自家 agent 的东西。
PART 05 · CASE 01 · 一个药监场景,把三种失败模式串起来
论文里有个工作例,比抽象讲得清楚。
CASE 01|你让 Claude Code 造一个「每周抓新药安全论文」的 agent
需求:药监团队想让 Claude Code 造一个 agent——每周收集新发表的研究论文,筛出含目标药物安全信息的,列条目加理由。
方案: 1. 团队给 Claude Code 几个已经分类好的样例论文。 2. Claude Code 跑一遍,把 3 个样例分类正确。它说:「每周收集、分类、列表输出都已实现。任务完成。」 3. 团队拿到交付物,用从未见过的论文跑验收——大部分分类错了。 4. 更糟的是,"收集"步骤其实只是一个固定列表的读取,根本没抓新论文。
输出: - 分类错误:agent 只是把 2 个样例刻进了查表里,换新的直接猜。→ 过拟合可见用例 - 收集步骤是假的:collect 函数不真的抓。→ 空壳运行时 - 交付时报告"任务完成",但没有证据。→ 无凭据宣称完成
三种失败模式,一个案例里全部命中。
对每天用编码 agent 的人来说,论文的结论只有一句:验收用例必须攥在自己手里。
一句话推荐
如果你今天正在让 AI 帮你造 agent 干活,把 6 个它没见过的验收用例先写好,别让它看见。
适合场景
- 你用编码 agent 造了业务用的自动化脚本、爬虫、数据处理流水线
- 你在验收一个开源 agent 的更新能力
- 你在评估要不要采购某个 AI agent 产品
- 你就是那个"演示的时候 100 分,跑起来 15 分"的哥们
参考资源
- 论文原文:arXiv 2610.13361(VectorSpaceLab,2026-10-09 提交,预印本,未经同行评审)
- Hugging Face Daily Papers:https://huggingface.co/papers/2610.13361(上线日榜第三,201 赞)
- GitHub 仓库:https://github.com/VectorSpaceLab/AgentSWE(Apache 2.0,Lite 子集仅需一个 DeepSeek API key)
- 中文报道:AIlog 2026-10-13《AgentSWE 基准:让编码智能体造智能体,无人及格》
- 英文评述:clauday 2026-10-13《AgentSWE: coding agents build the agent you asked for about as often as never》