AI TOOL · 数据观察 | 2026-10-28 你正准备转发「Ramp 74% 的代码是自家 agent 写的」——同一天,亚马逊说:别数这个。 数字亮点:74% 合并代码出自它 · 99% 团队在用 · 6x 人均产出 数据背书:Ramp 官方发布帖(2026-10-27)+ CNBC 报道(2026-10-27)
先看翻车现场。你刷到一条:Ramp 的 CTO 宣布,过去一个月公司 74% 的合并代码出自自家 agent「Inspect」,而去年 11 月这个数字还是零。你第一反应:卧槽,AI 已经把代码写掉四分之三了。
然后你往下刷到第二条:同一天,亚马逊发了份内部工程指南,说 token 用量、采纳率、代码变更数全是「deeply flawed」的指标,让你别数 PR,看长期结果。
同一天,一个让你想转发,一个让你闭嘴。哪个是真的?这稿就拆这个。
PART 01 · THE NUMBER · 74% 到底怎么来的
Ramp 是家做企业卡和财务软件的公司,不是搞 AI 的。它的 agent「Inspect」从今年 1 月就在自己内部跑,10 月 27 日才对外开早鸟。
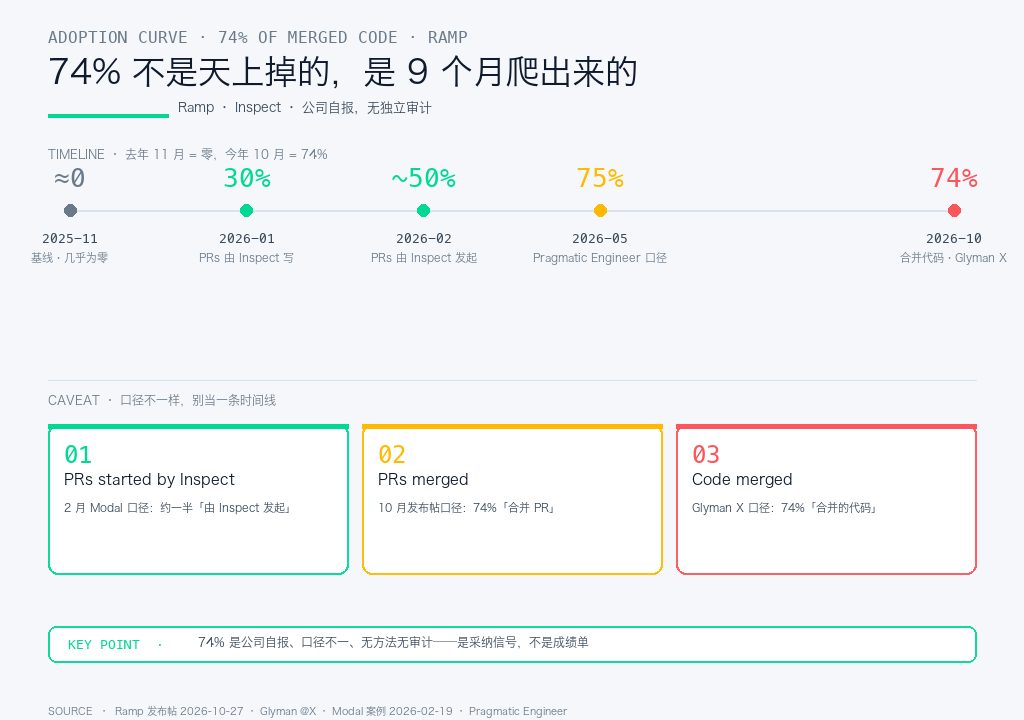
这个 74% 不是天上掉的,是爬出来的。看数字的进化史:
- 1 月(Ramp 工程博客):约 30% 的合并 PR「由 Inspect 写」
- 2 月(Modal 案例):约一半合并 PR「由 Inspect 发起」
- Pragmatic Engineer:60% 的 PR(1 月口径)→ 75%(5 月口径)
- 10 月(官方发布帖):74% 的合并 PR;联合创始人 Eric Glyman 在 X 上说得更直白——「我们合并的代码 74% 出自它,去年 11 月还接近零」
- 同一篇发布帖:过去一个月 99% 的工程/设计/产品团队用过;人均产出 6x(比一年前)
看到没?30% → half → 60% → 75% → 74%,一路往上。但这串数字有个坑:口径不一样。「PRs started by Inspect」「PRs merged」「code merged」是三个不同的量,不同来源在不同时点报的。74% 是公司高管自己说的,没给方法,也没独立审计——这是它最软的地方。
顺带一提,Ramp 不是唯一这么喊的。今年这种「自家 agent 写掉 X% 代码」的发布几乎成了标配——谁家没个内部 agent 都不好意思开产品发布会。区别在于:多数公司报的是「我们试了,效果不错」,Ramp 报的是一个接近 3/4 的占比,还顺手把「去年 11 月还是零」的基线甩出来。这个对比很聪明,因为它把「增长」两个字写在了脸上——但从另一面看,也说明 Ramp 的 agent 是9 个月内从零堆到 74% 的,不是什么十年磨一剑。
硬数字:74% / 零(去年 11 月)/ 30%→half→60%→75% / 99% / 6x
PART 02 · HOW IT'S BUILT · 它是怎么搭出来的
Ramp 没买现成的,是自己造的。为什么?它 1 月那篇博客说得直白:自家工具「只用在自家代码库上」,所以能做出「比任何 off-the-shelf 工具都强的东西」。
架构据 Modal 工程博客(2026-02-19):
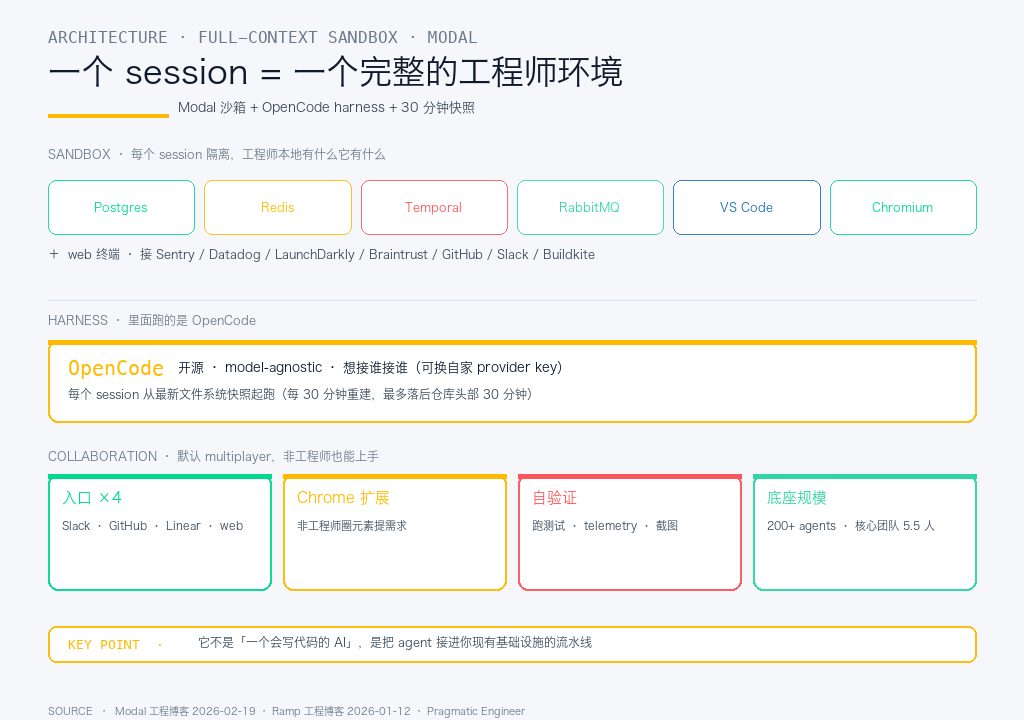
- 每个 session 一个隔离沙箱 VM(Modal),里面塞了 Postgres、Redis、Temporal、RabbitMQ、一个 VS Code server、一个 web 终端、一个 Chromium 浏览器——「工程师本地有什么,它有什么」
- 里面跑 OpenCode 当 harness——开源、model-agnostic,想接谁接谁
- 每 30 分钟 一个定时任务重建文件系统快照,新 session 从最新快照起跑,最多落后仓库头部 30 分钟
- 接到 Sentry、Datadog、LaunchDarkly、Braintrust、GitHub、Slack、Buildkite:后端能跑测试、看 telemetry、查 feature flags;前端能给你截图和 live preview
- 平台上一共 200+ 个 agent 在跑(code-review agent、on-call 助手、前端 QA、数据分析、客户反馈分析、从 Sentry/Datadog 告警自动起草 PR……),核心团队只有 5.5 个人
关键点:它不是「一个会写代码的 AI」,是一条把 agent 接进你现有基础设施的流水线。
硬数字:1 沙箱 / 5 服务 / 30 分钟快照 / 200+ agent / 5.5 人
PART 03 · WHO USES IT · 让非工程师也能写
Ramp 主打的是协作,不是单打独斗。
- 每个 session 默认 multiplayer:队友随时加进来加上下文、标约束、在评审前调方向
- 入口有四个:Slack、GitHub、Linear、web,外加一个 Chrome 扩展,让非工程师直接在页面上圈元素
- 官方例子:你上班路上在手机 App 里发现个 bug,截个图,在 Slack 里发「@inspect 修这个」,等你到工位,一份带着视觉证据的 PR 已经躺在那等评审
- 它把产品经理、设计师也拉进来了——所以才有 99% 的工程/设计/产品团队在用、人均 6x 产出
Ramp 自己的判断就一句:瓶颈「越来越是我们自己的判断」。
这句话是关键。代码变便宜了,评审没变便宜。Ramp 的答案是:把证据贴到 PR 上,让工程师做评审,而不是复现。同一天 Replit 的 Cloud Agents 也 GA 了(Pro/Enterprise),做法一样——agent 自己打开浏览器点一遍、截图、录屏,附在 PR 上。Replit 说把评审意见转成技能、工程师批了之后,自家 token 用降了 51%。
你看,两家公司的答案殊途同归:不是让 AI 更会写,而是让评审更省力。以前 PR 描述里写「改了啥」,现在直接附上「改完长这样、测试全过、feature flag 状态如此」——工程师要做的从「读懂代码」变成「看证据做判断」。这也是为什么 Ramp 敢说 99% 的团队都在用:因为门槛降了,非工程师也能上手,工程师不用替每一行代码背书。
硬数字:4 入口 / 99% / 6x / 51%
PART 04 · THE COUNTERPOINT · 同一天,亚马逊说别数这个
如果只看到这,你会觉得「AI 写代码已经赢麻了」。但同一天(10-27),亚马逊发了份内部 AI 工程指南,CNBC 报道了。
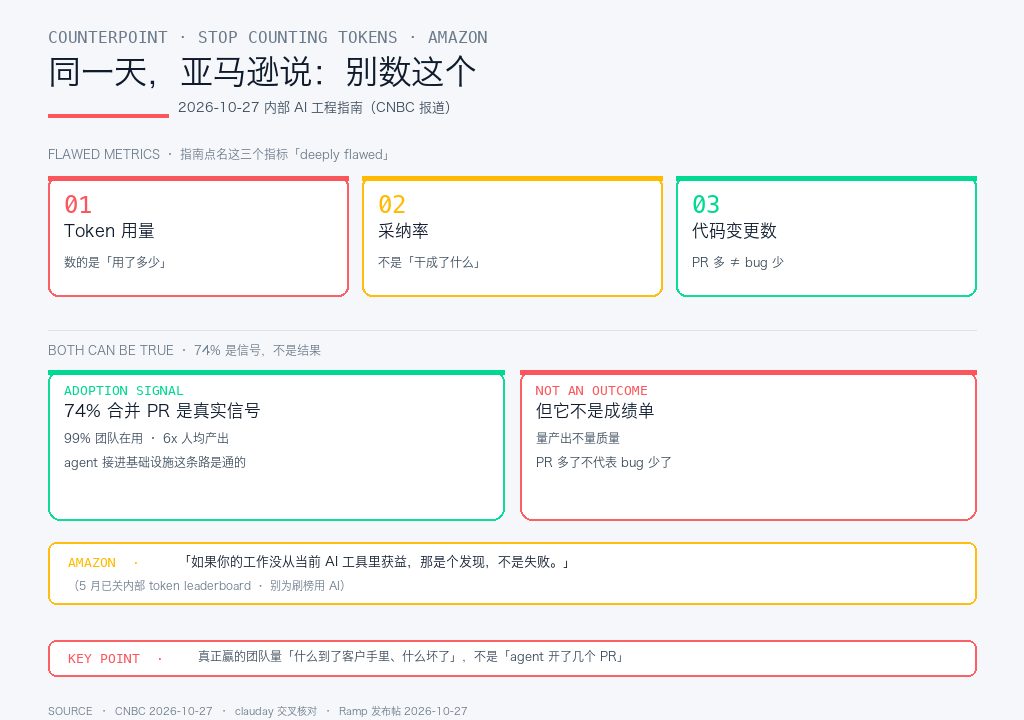
指南点名:token 用量、采纳率、代码变更数,这三个指标「deeply flawed」——它们数的是「用了多少」,不是「干成了什么」。亚马逊说要看长期结果,还特意提了一句:「如果你的工作没从当前 AI 工具里获益,那是个发现,不是失败。」("If your work does not benefit from current AI tooling, that is a finding, not a failing.")它在 5 月就把内部 token leaderboard 关了。
两边能同时为真:
- 74% 的合并 PR 是真实的采纳信号(adoption signal)
- 但它不是结果(outcome)
真正赢的团队,会是那些量「什么到了客户手里、什么坏了」的,而不是「agent 开了多少个 PR」的。
这里得多说一句,免得你误解成「亚马逊唱反调」。亚马逊不是否定 AI 写代码,它是否定用错误的方式衡量 AI。指南真正扎心的是那句「如果 AI 工具没让你的工作获益,那是个发现,不是失败」——意思是别为了指标好看硬上 AI,也别因为某个环节没用上 AI 就觉得丢人。它 5 月关 token leaderboard,就是不想让团队为了刷 token 榜而用 AI。这跟 Ramp 的 74% 不冲突:Ramp 证明了 agent 能扛起产出,亚马逊提醒你产出本身不是终点。
硬数字:3 个 flawed 指标 / 5 月关榜 / 74%
PART 05 · WHAT IT MEANS · 所以 74% 是信号还是自嗨
我的判断:是信号,但不是成绩单。
- 信号在哪:一家不做 AI 的金融科技公司,靠自家 agent 把合并代码干到 74%,说明「agent 接进现有基础设施」这条路是通的,不是实验室玩具
- 不是成绩单在哪:74% 是高管自报、口径不一(started/merged/code)、无方法无审计;更关键的是它量的是产出,不是质量——PR 多了不代表 bug 少了
- 真正的转折点:评审从「理解代码」变成「判断证据」。Ramp 说瓶颈是「我们自己的判断」,Amazon 说别数 PR 数结果——两边其实是同一句话
对你(1-5 年程序员)最实在的,是把这套思路抄回自己团队。
CASE 01|把「评审证据化」抄进自己团队
需求:你团队 agent 开始提 PR 了,但评审越来越费劲,你想把「评审」从复现变判断。
方案: 1. 让 agent 跑完测试、查完 telemetry 再提 PR,把证据(测试结果 / 截图 / feature flag 状态)附在 PR 描述里 2. 别用「agent 提了多少 PR」当 KPI,改用「到客户手里的结果」——线上 bug 率、回滚率、功能是否达标 3. 给非工程师一个入口(Slack 截图 @agent 修这个),把需求从口头变 PR 输出: - 评审从「复现代码」变成「判断证据」,省的是复现时间 - 团队 KPI 从「数 PR」变成「看结果」,Amazon 那套 - 非工程师能直接提需求,工程师只做判断
一句话推荐:别转发那个 74% 当谈资,转这条判断——代码变便宜了,判断才是新瓶颈。
适合场景: - 团队在用 agent 提 PR、评审变慢的 - 老板拿「AI 写了多少代码」当 KPI 的 - 想给非工程师开 AI 入口的
参考资源: - Ramp 发布帖:https://ramp.com/blog/introducing-inspect - Amazon 指南(CNBC):https://www.cnbc.com/2026/10/27/amazon-ai-coding-tokenmaxxing.html