DeepSeek 反手开源,账本也摊了
AI TOOL · 行业观察 | 10-20 DeepSeek 官方开源 DeepInfer + deepseek-recipe · 单集群 155 万亿 tokens/天 · 每卡每小时 38 美元 · 中国模型周调用量 4.56 倍美国
PART 01 · THE SETUP · 一天之内
10 月 19 日,美国国土安全部一纸命令下来:把 DeepSeek 及其关联实体的产品与服务,从美国联邦民用行政分支的采购渠道和 IT 系统里清除。原文用的是"清除",不是"暂停",不是"审查"。
第二天,也就是 10 月 20 日,DeepSeek 官方公众号发了一篇声明,标题不长:开源 DeepInfer。
DeepInfer 是什么?DeepSeek 内部实际跑生产服务的推理框架。不是模型权重,不是算子库,不是编译器——是那个真正把模型跑起来的调度层。这个调度层以前只有 DeepSeek 自己用,现在挂在 GitHub 上,谁都能拉。
顺手开源的还有 deepseek-recipe,一个生产级的 Token 编解码组件,跟官方 API 的处理逻辑完整对齐。
两天之内,一份禁令、一份开源公告,同一件事的正反两面。你要是这两天没盯推特和公众号,会以为这是两件事。
PART 02 · THE LEDGER · 账本摊了
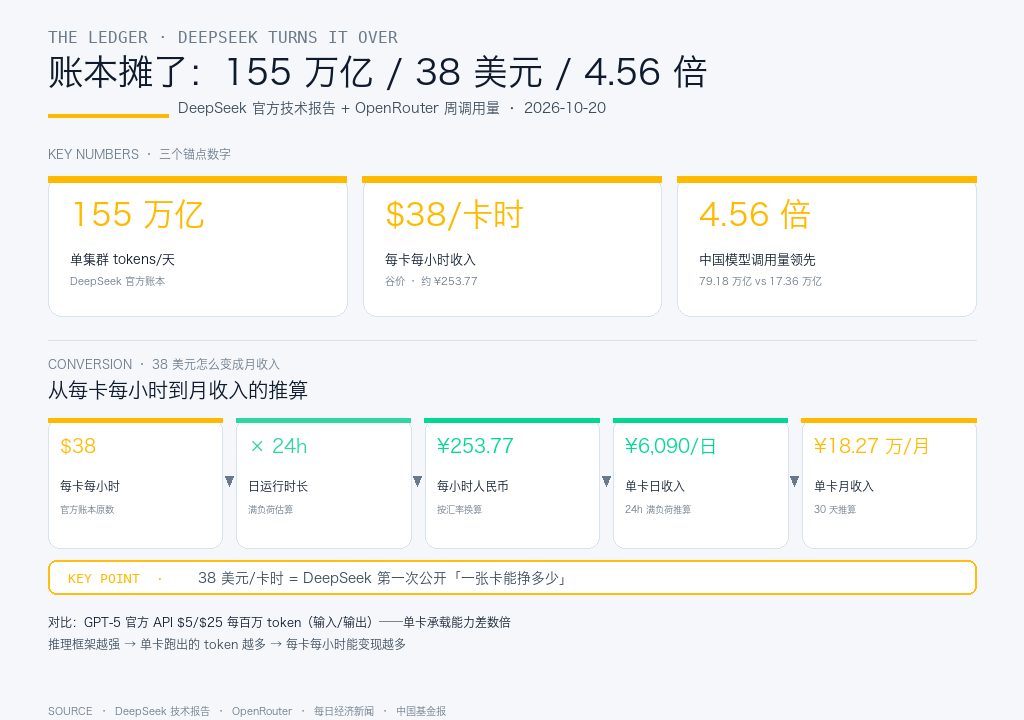
真正让人坐直的,是这次开源顺手带的另一件事——DeepSeek 第一次把内部推理服务的账本摊出来了。
技术报告里两个数字:
- 单一集群的服务吞吐:155 万亿 tokens/天
- 整体收入:每卡每小时 38 美元(按谷价,约合人民币 253.77 元)
按 24 小时满负荷粗算,一张卡一天跑下来大约能挣 6090 元人民币,一个月大约 18.27 万元。数字不算夸张,但它是 DeepSeek 唯一一次公开的"一张卡能挣多少"的锚点。
之前我们讨论 AI 服务成本,讨论的都是模型 API 单价——GPT 每百万 token 多少美元,Claude 每百万 token 多少美元。那些是卖 token 的价格。而 DeepSeek 这次摊出来的,是每卡每小时能变现多少。
这两个数字的关系就是推理框架的价值:模型能力不变,但推理框架变了,同样的卡能跑出多少 token、卖出去多少,全在框架层决定。过去这一层是黑箱,是各家不说的商业机密。现在 DeepSeek 自己把它翻出来了,还给了开源许可证。
顺带说一句 38 美元这个数怎么读。它不是"毛利",是"收入"——没扣电费、没扣机房、没扣人力。但对程序员来说它的用法很直接:以后有人跟你说"我们自建比调 API 便宜",你可以问他一句每卡每小时能跑出多少 token、变现多少,而不是只问一度电多少钱。过去这个问题没法问,因为没人给过锚点。
PART 03 · THE GLOBAL CALL · 谁在用
再看一组外部数据。
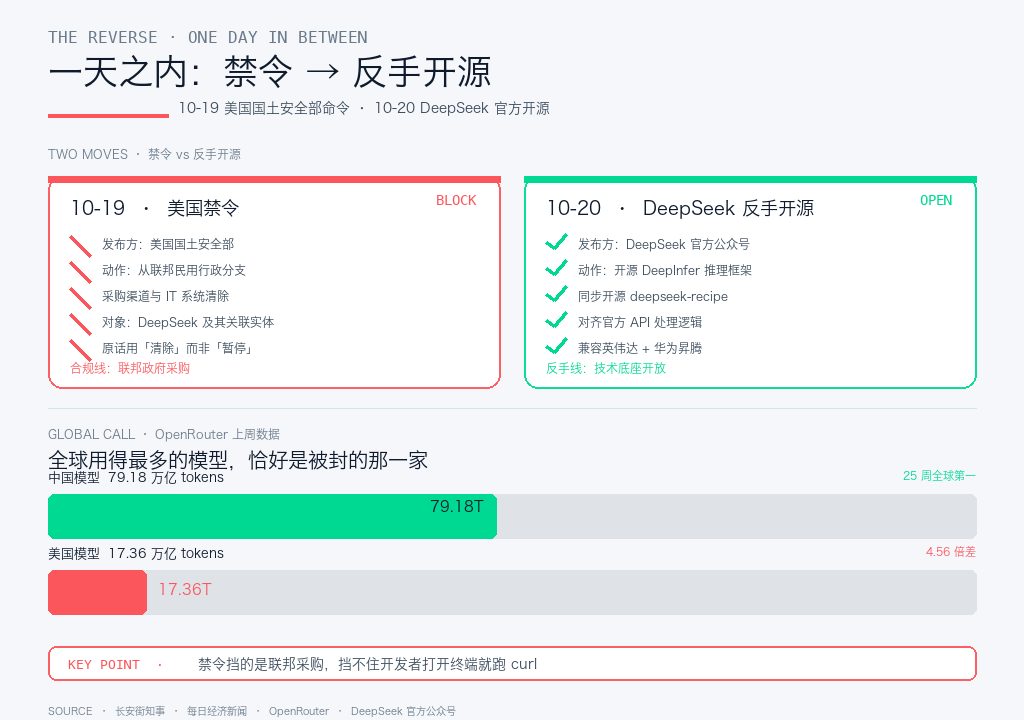
OpenRouter 上周(10 月 12 日到 18 日)全球 AI 大模型总调用量 164 万亿 tokens,环比下滑 4.65%。这个量级里,中国模型 79.18 万亿 tokens,美国模型 17.36 万亿——比值 4.56 倍。这是 OpenRouter 数据连续第 25 周中国模型领先。
前五名清一色中国模型,DeepSeek V4.1 Flash 连续数周居首,智谱、小米、腾讯紧随其后。
被美国官方挡在联邦采购渠道外的那家公司,恰是全球开发者用真实调用量投票选出的"最常用"其中之一。禁令挡的是美国联邦政府采购的合规线,挡不住全球开发者打开终端就跑 curl。
这条数据本身不难找,难的是它跟 DeepSeek 10-20 反手开源的时间线叠在一起——禁令发出去第二天,被禁的那家把"你怎么跑我"也发出来了。
PART 04 · THE INFER LAYER · 推理框架才是杠杆
过去两三年,行业讨论大模型,几乎只讨论模型本身:参数规模、benchmark、上下文长度、幻觉率。
DeepInfer 开源把讨论拉到了另一个层面上——推理框架。
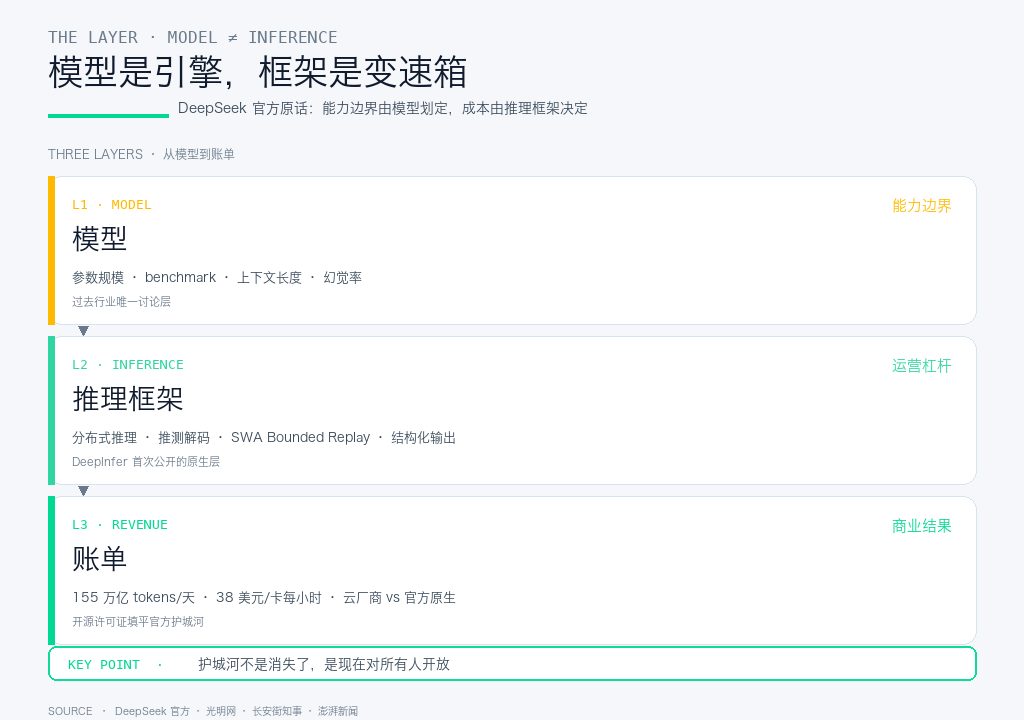
DeepSeek 官方原话:「大模型的能力边界由模型本身划定,但如何以合理成本提供超大规模的模型服务,还取决于一个长期未被公众了解的中间层:推理框架。」
这句话翻译过来就是:模型是发动机,推理框架是变速箱。发动机再好,变速箱拉胯,车也跑不快、油也费得多。
DeepInfer 集成的高性能算子、分布式推理、推测解码、SWA Bounded Replay、结构化输出,都在这层。兼容英伟达和华为昇腾双平台。
为什么以前没人开?因为开模型权重是"送模型",开推理框架是"送产能"。模型权重你拉下来还得自己搞定怎么跑,推理框架直接告诉你怎么在几千张卡上把它跑满、跑便宜。前者是技术影响力,后者是把自己的成本结构摊给同行看——这也是为什么这次摊账本比开源本身更罕见。
全球头部大模型企业里,这是第一次有厂商把原生实际运行的推理框架开源。之前各家开源的都是模型权重或工具链,"实际跑生产的那套"从来没开过。
这里有个不太舒服但很重要的推论:云厂商可以用 DeepInfer 部署 DeepSeek V4.1 Flash,达到接近官方原生的性能。也就是说,DeepSeek 官方 API 的"官方原生"这条护城河,正被开源许可证填平。大规模云厂商部署非原生 DeepSeek 的成本,甚至可能低于官方原生。
不是护城河消失了——是护城河现在对所有人开放。
PART 05 · THE REVERSE · 反手
把这三件事串起来看:
- 模型能力强 = 全球开发者用脚投票 → 79.18 万亿 tokens 领先
- 推理框架强 = 每卡每小时 38 美元 → 单集群 155 万亿 tokens/天
- 官方 API 定价 = 有护城河 → 现在开源框架填平它
反手开源这个动作,不是简单的"你封我我就开源"的表态。它是把三件事同时做完:
- 对外:把"被封禁"的叙事反转成"最被使用的模型"
- 对内:把推理框架变成公共基础设施,降低自己的边际成本
- 对行业:告诉所有人,模型能力的下限不再是模型本身,而是跑模型的整套系统
这不是免费,这是定价杠杆。
过去 AI 编程工具的行业叙事是「模型降价 → 所有人受益」。DeepSeek 反手开源之后,行业叙事多了一层——「推理框架开源 → 云厂商受益,官方原生受压」。
这一层的账单,程序员暂时不用管,但云厂商的产品经理已经在开会了。
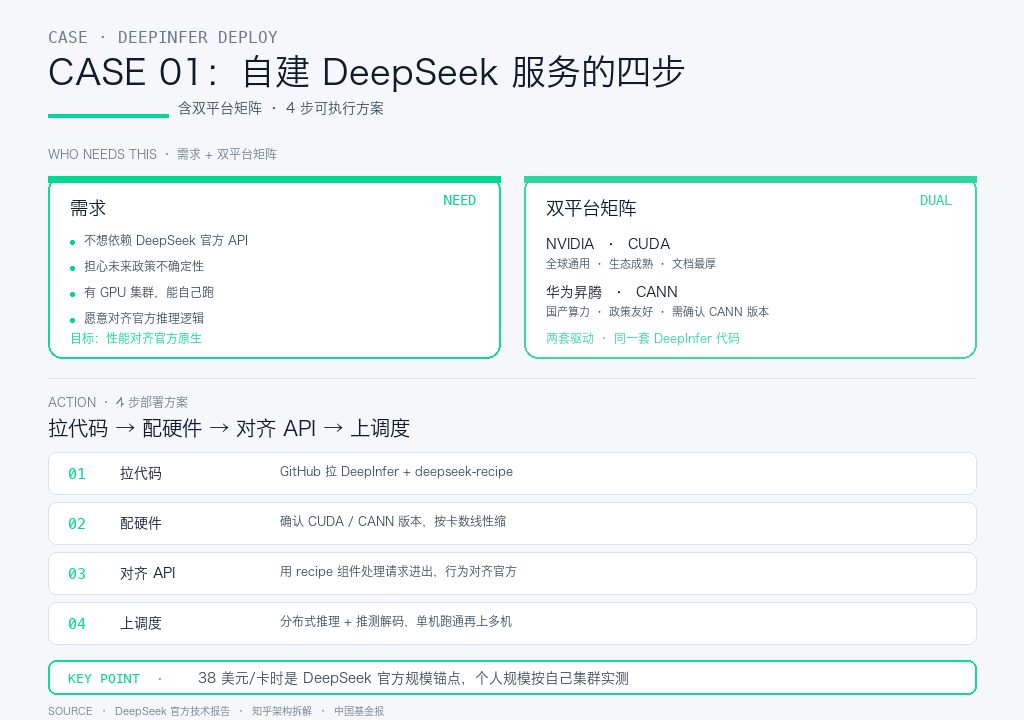
CASE 01|自己部署 DeepInfer 的四步
不是每个人都打算自建 DeepSeek 服务。但对有 GPU 集群、又担心 DeepSeek 官方 API 未来政策不确定的人来说,DeepInfer 值得看一眼——你不一定现在就用,但至少得知道这条路已经开着了。
需求:不用 DeepSeek 官方 API,用 DeepInfer 自建 DeepSeek V4.1 Flash 服务,性能对齐官方。
方案: 1. 拉代码:GitHub 拉 DeepInfer 主仓库 + deepseek-recipe,clone 下来先看 README,确认自己是英伟达平台还是昇腾平台 2. 配硬件:按报告说的,单集群目标吞吐 155 万亿 tokens/天是 DeepSeek 自己的规模,个人自建按自己 GPU 卡数线性缩;英伟达侧确认 CUDA 版本,昇腾侧确认 CANN 版本 3. 对齐 API:用 deepseek-recipe 组件处理请求进出,这一步的关键是"跟官方 API 处理逻辑完整对齐"——DeepSeek 官方明确说了这一点对齐,第三方部署出来的接口行为才跟官方一致 4. 上调度:DeepInfer 内置分布式推理和推测解码,单机先跑通再上多机;结构化输出这块对做 agent 的程序员是关键
输出:一套跑 DeepSeek V4.1 Flash 的服务,性能接近 DeepSeek 官方原生,账单自己承担——每卡每小时目标 38 美元是 DeepSeek 官方规模下的锚点,个人规模下的实际数字要按自己集群实测。
一句话推荐
DeepSeek 反手开源不是免费的姿态,是定价杠杆——推理框架这次不再是黑箱,账单结构变了,AI 服务的成本叙事也要跟着重写。
适合场景
- 有 GPU 集群、想自建 DeepSeek 服务避开官方 API 政策风险的技术团队
- 做 AI 编程工具商业模型的创业公司,需要重新评估模型 API 依赖度
- 关注中美大模型路线的行业观察者和政策研究者
参考资源
- DeepSeek 官方公众号:DeepInfer 开源声明与 deepseek-recipe 组件介绍(2026-10-20)
- DeepSeek 技术报告:DeepInfer 架构与单集群吞吐、单卡收入披露
- 每日经济新闻 · OpenRouter 周调用量数据:中国模型 79.18 万亿 vs 美国 17.36 万亿(10-12 至 10-18)
- 长安街知事、光明网、中国基金报、中新经纬:DeepInfer 开源与账本复算报道
这篇拆的是"推理框架"这层以前没人摊开讲的东西。后面还会继续盯各家把生产级的东西往外放的案例——想看下一次是谁摊账本,点个关注,别等别人转给你。