4 个月,AI 手搓了个 40B 编程模型
老魏|AI 编程工具观察 | 田渊栋 + Richard Socher 创业 5 个月交首份答卷 · Flint 40B MoE 4 个月从零训练 · MacBook M4 Pro 131 tok/s · SWE-bench Verified 74.2% · Apache 2.0 开源 · Recursive 官方 blog + Wired + TechCrunch + The Decoder 交叉验证
上周有哥们问:Recursive 那个田渊栋创业的公司到底造出东西没有?
我说:造了。而且是拿 AI 造的。
他说:AI 造 AI,那不是自己给自己打广告?
我说:你先看完再问。
PART 01 · THE TEAM · 4 个月的小团队
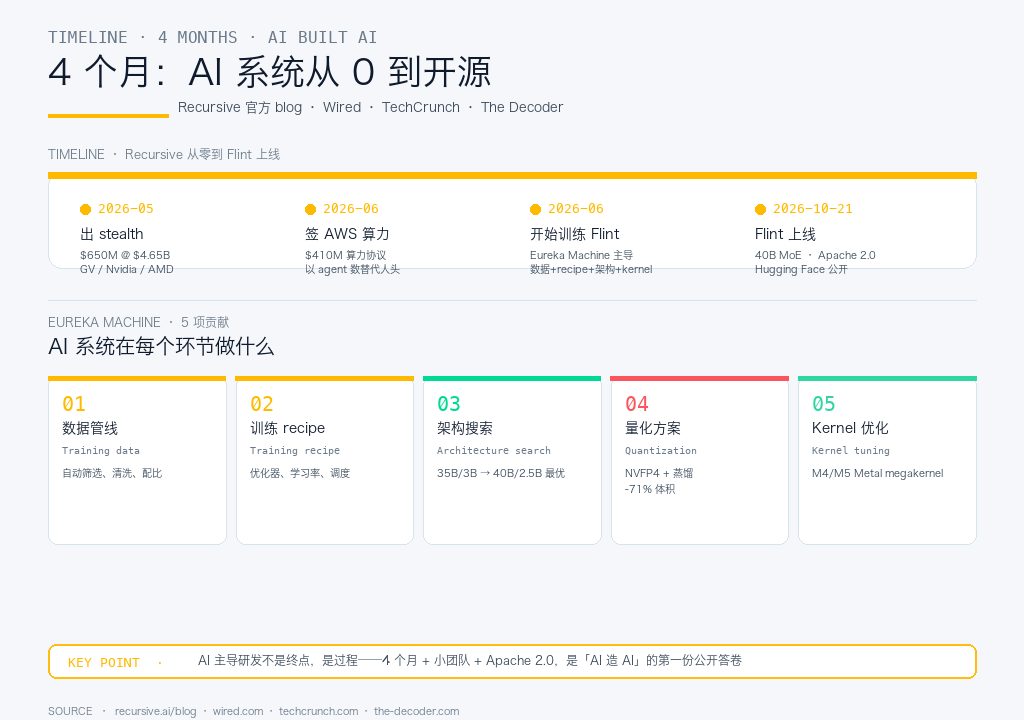
Recursive 5 月出 stealth 的时候,融资 $650M,估值 $4.65B,投资人名单是 GV、Nvidia、AMD Ventures 这些熟脸。创始人 Richard Socher 是前 Salesforce 首席科学家、提示工程之父;联合创始人田渊栋是 YOLO 算法原创者,前 Meta 首席研究员。
当时他们手里没一个能拿出手的模型,只有一个承诺——「recursive self-improvement」,也就是让 AI 系统自己主导自己的研发。半年没影。
10 月 21 日(美西时间),Flint-40B-A2B 挂了 Hugging Face,Apache 2.0 授权。整个模型从零训练到发版,不到 4 个月。
Recursive 官方和 CEO Socher 对 Wired 的原话是:「Nearly every aspect of the entire model pipeline was actually done and improved upon by AI.」 翻译成程序员听得懂的话——数据管线、训练 recipe、架构搜索、量化方案、推理 kernel,这些活 AI 系统 Eureka Machine 自己拟题、自己跑、自己评估、自己决定下一步,人类只做两件事:定目标、按暂停键。
这不是终点,但这是「AI 造 AI」第一次拿出公开可复现的东西。
PART 02 · THE MODEL · 40B 塞进笔记本
Flint 是 MoE 架构:总参数 39.8B,每个 token 只激活 2.5B 参数。每层 256 个路由专家,每个 token 选 6 个 + 1 个共享专家常驻。上下文最长 512K,官方建议压到 256K。
关键动作有两个:
一是 Eureka 自己做架构搜索。基线是 35B 总参 / 3B 激活。Eureka 在多个候选配置里跑,最后选出了 40B / 2.5B 这个组合——比基线总参还大、激活还小,速度和能力的取舍点被 AI 挑了出来。
二是 Eureka 自己反常做量化。常规做法是权重 4-bit、输出层保留高精度。Eureka 把输出层 lm_head 也压到 NVFP4,模型体积再降 71%;然后用 16-bit 教师模型离线蒸馏一次,把训练步数砍掉近半,NVFP4 版本跟 16-bit 版本在 benchmark 上只差 0.7 分。
再加一个 M4/M5 芯片专用的 Metal megakernel——把整个解码前向融合成单 kernel,消除 launch 开销。
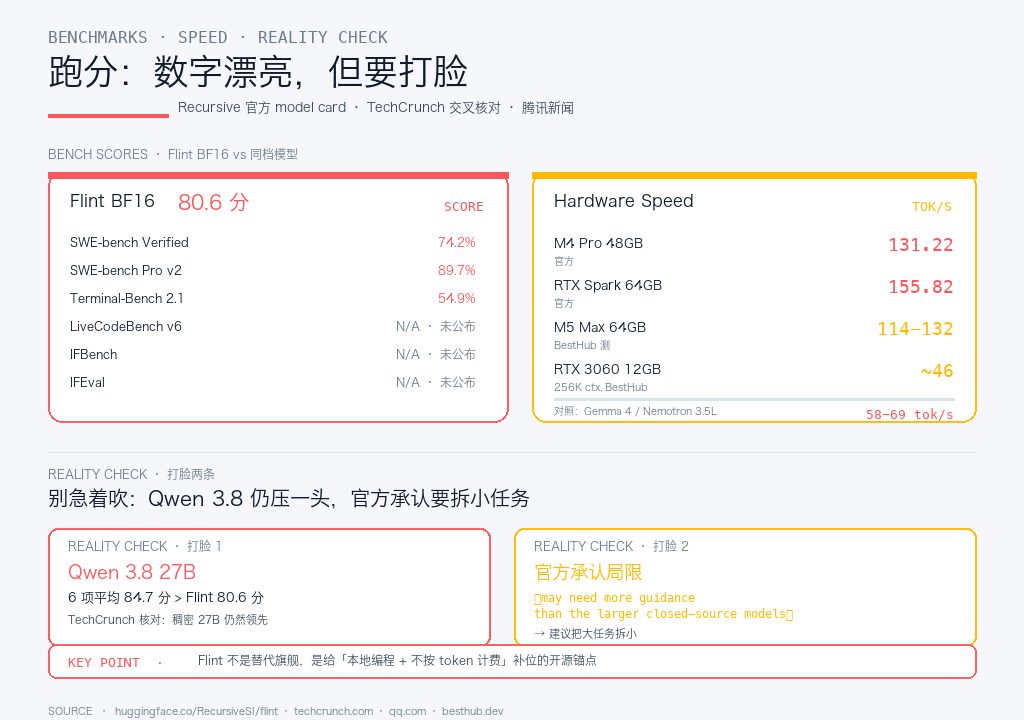
三层优化叠一起,Flint 在 MacBook Pro M4 Pro(48GB)上跑到 131 tok/s,Nvidia RTX Spark(64GB)上跑到 155 tok/s。Wired 的 Will Knight 亲测:「nailed my coding requests every time」——写 to-do 应用、写 web 检索工具,一次通过。
PART 03 · THE NUMBERS · 跑分和速度的真相
跑分这块,得把 Recursive 的宣传话跟第三方视角分开看。
Recursive 官方口径:MoE < 50B 参数范围内,SWE-bench Verified 74.2% / SWE-bench Pro v2 89.7% / Terminal-Bench 2.1 54.9% / LiveCodeBench v6 / IFBench / IFEval 六项全部第一。
TechCrunch 交叉核对后:在 Recursive 自己给的六项平均里,Flint BF16 版 80.6 分,Alibaba 的 Qwen 3.8 27B 仍然以 84.7 分排在它上面。腾讯新闻报道里 Qwen 3.6 71.7、Qwen 3.5 68.9,Muse Glimmer 74.8,Qwen 3.8 是唯一压过 Flint 的稠密模型。
速度侧更实在:TechCrunch 报的对照组数据——Google Gemma 4 和 Nvidia Nemotron 3.5 Lightning 在同一台 M4 Pro 上跑 58-69 tok/s,Flint 是 131 tok/s,整整 2 倍。BestHub 汇总的独立开发者实测:M5 Max 64GB 114-132 tok/s,RTX 3060 12GB VRAM 也能跑到 ~46 tok/s(256K 上下文)。
Recursive 自己也承认一句:「Flint may need more guidance than the larger closed-source coding models you're used to」——建议把大任务拆小,别指望它一次吃下一整段需求。
换句话说,Flint 不是来替代 GPT-5 或 Claude 4 的旗舰,是来给「本地 agent 编程」这条赛道补位的。你不想把代码送云端计费,也不想被订阅额度卡脖子,Flint 是最省事的一条路——Apache 2.0,权重 Hugging Face 上直接下,rec / llama.cpp / Ollama / LM Studio / vLLM / SGLang 都能跑。
对照 Meta 上周发的 Muse Spark Open——816B 参数、至少 1TB 内存起步。Recursive 押「小 + 本地 + 自研 kernel」,Meta 押「大 + 云端 + 硬件捆绑」,同一起跑线两条腿已经分叉。
PART 04 · THE TAKE · 递进 DeepSeek
把 10-22 DeepSeek 反手开源和今天的 Flint 放一起看,其实是同一件事的两面:
- DeepSeek 开的是推理框架——送产能,摊护城河
- Recursive 开的是本地模型 + 推理引擎——送工具链,摊研发方式
两条路线殊途同归:2026 年的开源不是姿态,是竞争杠杆。
不过别急着喊「RSI 时代到了」。Flint 是过程,不是终点。Recursive 说 Eureka Machine 的长期目标是「build recursively self-improving superintelligence」——这个目标还没兑现,而且美国国会有议员正在提法案要禁掉这条路径。今天能说的更扎实一点是:AI 系统主导模型研发的每个环节(数据、recipe、架构、量化、kernel)已经被验证过一次,代价是 4 个月、一个小团队、和一份 Apache 2.0。
对程序员来说,这事的意义很具体:
- 本地编程不再只是"玩具模型"——Flint 的 2.5B 激活 + 131 tok/s + 256K 上下文,日常脚本、单元测试、修 bug 已经够用
- 本地模型的成本账算得过来了——不用按 token 计费,不用订阅 $20 起,硬件是固定资产,边际成本几乎为零
- 开源 ≠ 免费送——Recursive 融资 $650M、签 $410M AWS 算力协议,开源的是首个模型,闭源的是 Eureka Machine 本身。他们卖的不是模型,是「AI 造 AI」这个能力的入场券
CASE 01|本地部署 Flint 的四步
需求:不接云 API,用 Flint 在自己机器上跑日常编程 agent。
方案:
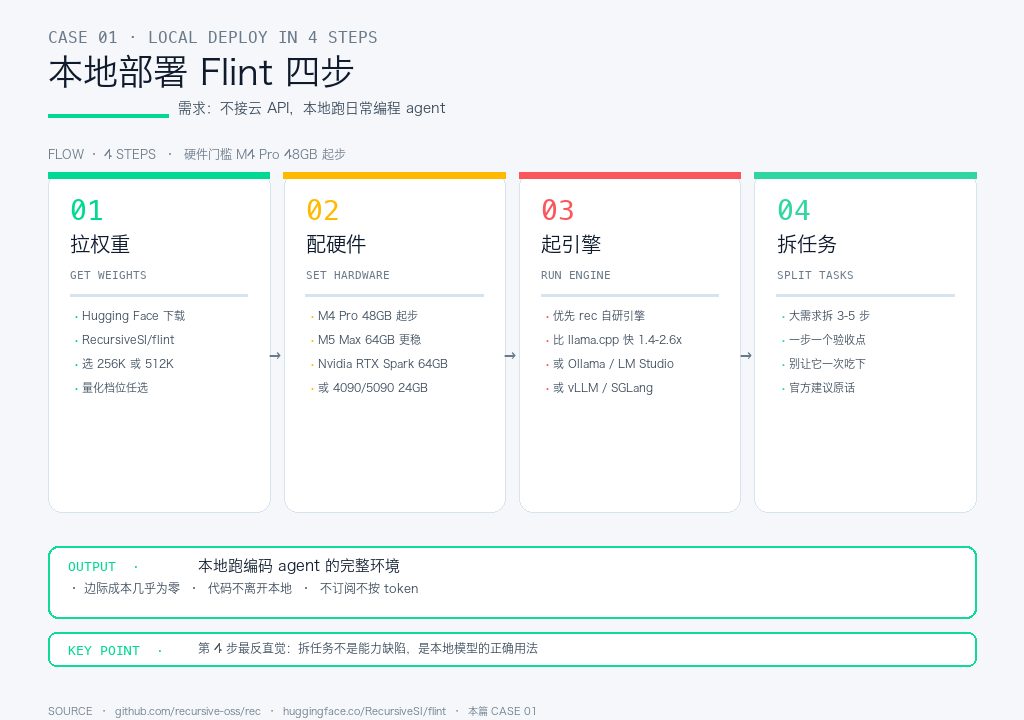
- 拉权重:Hugging Face 下 RecursiveSI/flint,看你要用 256K 还是 512K 上下文,选对应量化档位
- 配硬件:M4 Pro 48GB 起步,M5 Max 64GB 更稳;Nvidia 侧 RTX Spark 64GB 或 RTX 4090/5090 24GB 走 GGUF 量化
- 起引擎:优先用 Recursive 自研 rec(github.com/recursive-oss/rec),Metal 优化后比 llama.cpp 快 1.4-2.6 倍;不想折腾就用 Ollama 或 LM Studio
- 拆任务:Recursive 官方建议把大需求拆成 3-5 步小任务,一步一个明确验收点——这是 Flint 跟 Claude / Codex 最不一样的地方,别指望它一次做完
输出:一台不需要云 API 就能跑编码 agent 的本地环境,边际成本几乎为零,代码不离开本地。
SUMMARY · 一句话结论
「AI 造 AI」不再是伪命题,但也不是终点——Recursive 用 4 个月 + 小团队 + Apache 2.0 交出的第一份答卷,是本地编程模型的一个可行锚点。
Flint 不是替代旗舰,是给「不想按 token 计费、不想把代码送上云、不想被订阅额度卡脖子」这批人留的一个出口。
适合:有 M4 Pro / M5 Max / 单卡 24GB+ 的程序员;想用本地 agent 写脚本、修 bug、跑单元测试又不想按 token 付费的团队;关注 RSI 这条赛道的行业观察者。
参考:Recursive 官方 blog · Wired《Socher: Nearly every aspect was done by AI》· TechCrunch《Recursive shows first result of its AI-driven research process with Flint》· The Decoder《Flint leads coding benchmarks》· 腾讯新闻《田渊栋的「AI 造 AI」第一次交作业》· 量子位《4 个月 RSI 从 0 训练》· BestHub《Flint-40B-A2B AI-Built MoE Coding Model》· Hugging Face: huggingface.co/RecursiveSI/flint · GitHub: github.com/recursive-oss/rec